
Aller au contenu principal
RecherchearXiv cs.RO 

RAIWAY : un robot bipède à grandes roues avec une locomotion aveugle guidée par le contact
1 source couvre ce sujet·Source originale ↗·
Résumé IASource uniqueImpact UE
RAIWAY : un robot bipède à grandes roues avec une locomotion aveugle guidée par le contact
▶ Voir sur YouTube

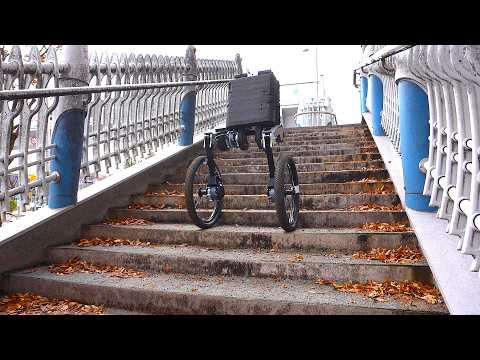
RAIWAY est un robot bipède à roues conçu en interne par ses auteurs, équipé de roues de 20 pouces (environ 51 cm), décrit dans un preprint arXiv (2610.33172v1) accompagné d'une vidéo de démonstration. L'équipe y associe à la plateforme une méthode de contrôle « informée par le contact » pour rouler en aveugle, sans caméra ni capteur de terrain, sur des sols irréguliers et discontinus. Le principe est le suivant : en simulation, le système accède à toutes les informations de contact entre roues et sol, qu'il distille en une représentation latente compacte. Au déploiement, le contrôleur reconstruit cette représentation en ligne à partir de la seule proprioception (états articulaires, centrale inertielle), sans aucun capteur de contact. Les essais réels couvrent des pentes raides, des lits de gravier, des surfaces à plots et des terrains rocheux, ainsi que la montée continue d'escaliers extérieurs dont les contremarches atteignent 15 cm. Les auteurs indiquent que le contrôleur surpasse des variantes sans le mécanisme de contact, en intérieur comme en extérieur. Le résumé ne donne ni masse, ni nombre de degrés de liberté, ni charge utile, ni taux de réussite chiffré.

L'intérêt tient à la combinaison de grandes roues et d'un châssis bipède, qui vise à concilier l'efficacité énergétique et la vitesse du roulage avec une franchissabilité proche de celle des robots à jambes. Le contact roue-sol dépend de la déformation du terrain, du glissement et de la géométrie locale, et ne peut guère être instrumenté directement. Apprendre à l'inférer à partir de la proprioception est une réponse pragmatique, qui évite des capteurs fragiles et coûteux sur le robot. C'est un résultat de laboratoire sur un seul prototype, validé sur des parcours choisis par les auteurs et comparé à des références dont le preprint ne détaille pas la force. Il ne dit rien de la robustesse sur la durée, de la fiabilité en milieu industriel ni du coût. Pour un intégrateur, c'est un signal de recherche plus qu'une offre de produit, et le franchissement de marches de 15 cm reste modeste face aux escaliers standards.

Ce travail s'inscrit dans la lignée des robots hybrides roues-jambes, comme le Ascento issu de l'ETH Zurich, le Tron 1 de LimX Dynamics ou les quadrupèdes à roues de ANYbotics et Unitree, qui explorent tous la locomotion apprise par apprentissage par renforcement avec transfert de la simulation au réel. Les humanoïdes à jambes pures, eux, misent sur la polyvalence au prix d'une consommation plus élevée. Aucune commercialisation, aucun pilote ni calendrier n'est annoncé : il s'agit d'une plateforme interne dont les prochaines étapes probables sont la publication du code ou de données, des comparaisons plus larges et l'ajout d'une perception extéroceptive pour dépasser les limites de la locomotion aveugle.

Impact France/UE

Pas d\'impact direct sur la France/UE

Dans nos dossiers

À lire aussi

Glissement d'objets par manipulation des pieds sur un robot bipède à roues avec contrôle hiérarchique
1arXiv cs.RO 

Glissement d'objets par manipulation des pieds sur un robot bipède à roues avec contrôle hiérarchique

Des chercheurs ont publié sur arXiv (arXiv:2606.19233, juin 2026) un framework de contrôle hiérarchique permettant à des robots bipèdes à roues d'effectuer des tâches de manipulation d'objets au sol à l'aide de leurs membres inférieurs motorisés, une capacité baptisée "pédimanipulation mobile". Le système repose sur un contrôleur prédictif non linéaire (NMPC) construit sur un modèle dynamique simplifié à trois corps rigides (TRB), intégrant explicitement le degré de liberté en roulis de hanche et plusieurs modes de contact roue-sol. En expérimentation réelle, le robot a récupéré un objet de 1 kg coincé sous un bureau et déplacé latéralement un objet de 4 kg sur une distance de 0,228 m via une motion de type "scooting". Deux primitives de mouvement ont été validées sur hardware : scooting (poussée frontale par rotation des roues) et lateral sliding (déplacement latéral par pas de côté). L'intérêt industriel de cette approche réside dans sa réutilisation du train roulant comme effecteur de manipulation, sans bras supplémentaire ni outil dédié. Le NMPC régule simultanément la locomotion et les forces d'interaction, ce qui signifie que le robot maintient son équilibre tout en exerçant un effort contrôlé sur l'objet, un problème de couplage non trivial. Le planificateur de trajectoire intègre les transitions adhérence-glissement (stick-slip) dans le contact sol-objet, un phénomène souvent ignoré dans les démos en simulation mais critique en conditions réelles. C'est un résultat concret qui réduit le demo-to-reality gap sur la manipulation au sol, habituellement dominée par les manipulateurs à bras. Les robots bipèdes à roues constituent une architecture émergente entre AMR classiques et humanoïdes complets : Agility Robotics (Digit), Boston Dynamics (Spot avec extension roues dans certaines configs), et des plateformes académiques comme le Cassie de l'Oregon State University ont popularisé cette morphologie. Ce travail s'inscrit dans un courant de recherche sur la pédimanipulation, utiliser les jambes comme manipulateurs, que l'on retrouve aussi sur quadrupèdes (ANYmal, Go2). La prochaine étape probable est l'extension à des objets non rigides ou à des surfaces non planes, ainsi que l'intégration de perception pour fermer la boucle en environnement non structuré.

RecherchePaper
1 source
LocoWM : locomotion de haute précision grâce à une adaptation résiduelle guidée par un modèle du monde
2arXiv cs.RO 

LocoWM : locomotion de haute précision grâce à une adaptation résiduelle guidée par un modèle du monde

LocoWM est un cadre de contrôle publié sur arXiv (version 1, identifiant 2609.39179) qui vise la locomotion de haute précision, c'est-à-dire le suivi de commandes de mouvement associé à une régulation fine d'états physiques utiles à la tâche. L'architecture combine trois briques. Une politique de base assure la locomotion qui suit les commandes. Un modèle du monde conditionné par l'action prédit une séquence d'états physiques futurs à partir de l'historique proprioceptif et de l'action proposée par la politique de base. Un adaptateur résiduel, alimenté par cette séquence prédite, produit des corrections additives censées compenser les écarts anticipés. L'entraînement se fait en deux étapes : la locomotion et la dynamique conditionnée par l'action sont d'abord apprises, puis les deux modules sont gelés pendant l'entraînement de l'adaptateur. Les auteurs testent trois scénarios, le nivellement de terrain, la compensation d'accélération et la récupération après poussée. Ils annoncent une meilleure précision de contrôle et une meilleure robustesse aux perturbations que des références de bout en bout et des références résiduelles réactives. Démonstrations et code sont publiés en ligne. Le résumé ne donne aucun chiffre, aucun robot ni aucune plateforme matérielle. L'intérêt tient à un problème connu de l'apprentissage par renforcement pour la marche. Une optimisation conjointe de bout en bout sacrifie souvent les objectifs de précision au profit du suivi de vitesse et de la stabilité, car ces derniers dominent la récompense. Les correcteurs résiduels réactifs, eux, n'agissent qu'une fois l'écart observable, donc trop tard pour des tâches où la tolérance est serrée, par exemple porter une charge, niveler un sol ou tenir une posture en mouvement. Le caractère « préactif » de LocoWM, qui corrige avant que l'erreur ne se manifeste, répond à ce défaut. La séparation entre l'acquisition de la locomotion et l'adaptation de précision est aussi un choix d'ingénierie utile : la politique de base reste intacte et la couche de précision se greffe par-dessus. Reste à vérifier que cela tient au-delà de la simulation. Le résumé ne précise ni le transfert sim-to-real, ni le coût de calcul du modèle du monde à l'inférence, ni l'ampleur des gains. Il s'agit d'un travail de recherche et non d'un produit, sans déploiement industriel. Ce travail s'inscrit dans le courant qui rapproche modèles du monde et contrôle bas niveau pour les robots à pattes et humanoïdes. Il existe déjà des politiques de locomotion apprises en simulation, des architectures à correction résiduelle et des modèles dynamiques appris pour la planification. Les acteurs industriels de l'humanoïde, comme Figure, Tesla ou Agility, dépendent de telles couches de contrôle bas niveau, sans qu'un lien avec LocoWM soit établi ici. Aucun calendrier de suite n'est annoncé. Les prochaines étapes à surveiller sont la validation sur robot réel, la comparaison chiffrée avec les méthodes existantes et la réutilisation du code publié par d'autres laboratoires.

UEPas d\'impact direct sur la France/UE

RecherchePaper
1 source
ReCo : locomotion cohérente avec la réponse de la politique grâce à une MPC adaptée, pour la manipulation par robots à pattes
3arXiv cs.RO 

ReCo : locomotion cohérente avec la réponse de la politique grâce à une MPC adaptée, pour la manipulation par robots à pattes

Des chercheurs publient sur arXiv ReCo (Response-Consistent Locomotion), un cadre logiciel pour la manipulation continue sur robots à pattes, c'est-à-dire la tâche qui consiste à suivre précisément une trajectoire avec l'effecteur d'un bras pendant que la base continue de marcher. L'approche combine apprentissage par renforcement (RL) et commande prédictive (MPC). La politique apprise assure une locomotion robuste, tandis que le MPC coordonne la base et le bras pour compenser les erreurs de suivi. La contribution tient en deux briques. Un « response shaping » entraîne la politique à répondre aux commandes de façon cohérente et répétable malgré des dynamiques randomisées. Un modèle de réponse en boucle fermée, identifié ensuite, permet au MPC de planifier conjointement les commandes de locomotion et le mouvement du bras. Sur un benchmark en simulation, ReCo réduit l'erreur quadratique moyenne (RMSE) de position de 28,7 % et celle d'orientation de 27,4 % par rapport au meilleur point de comparaison pour chaque métrique. Des essais sur robot réel démontrent une manipulation continue embarquée, base et bras coordonnés. Le résumé ne précise ni la plateforme, ni la charge utile, ni les temps de cycle. L'enjeu est un problème que connaissent bien les intégrateurs de robots mobiles manipulateurs. Le MPC ne peut compenser que le mouvement de base qu'il sait prédire. Or la réponse d'une politique RL à une commande de vitesse varie avec la phase de marche, les contacts et la charge portée. Cette variabilité rend la compensation imprécise précisément quand le robot transporte quelque chose ou marche sur un sol irrégulier. Rendre la réponse de la politique prévisible plutôt que la corriger après coup est une voie pragmatique pour rapprocher les politiques apprises des contrôleurs à modèle, sans renoncer à la robustesse du RL. Pour un décideur industriel, cela concerne la précision en conditions réelles, souvent le point faible des démonstrations de manipulation sur quadrupèdes. Les gains annoncés restent toutefois mesurés en simulation, face à des références choisies par les auteurs, et la validation matérielle semble qualitative. Il s'agit d'un résultat de recherche, sans produit ni déploiement associé. Ces travaux s'inscrivent dans la lignée de la manipulation « loco-manipulation » sur quadrupèdes équipés d'un bras, où deux écoles s'opposent. L'une repose sur des politiques RL de bout en bout pour l'ensemble du corps. L'autre est hybride, avec un RL pour la marche et une optimisation pour le bras. ReCo se range dans la seconde. Elle vise à combler l'écart entre une politique de marche opaque et un planificateur qui a besoin d'un modèle fiable. La suite logique serait des essais sur d'autres plateformes, avec des charges variées et des tâches plus longues, ainsi qu'une comparaison avec des politiques de corps entier entraînées de bout en bout. Le texte n'annonce aucun calendrier de ce type.

UEPas d\'impact direct sur la France/UE

RecherchePaper
1 source
GeCCo : une politique généraliste conditionnée par le contact pour la loco-manipulation des robots à pattes
4arXiv cs.RO 

GeCCo : une politique généraliste conditionnée par le contact pour la loco-manipulation des robots à pattes

GeCCo, pour Generalist Contact-Conditioned Policy, est une politique de bas niveau entraînée par apprentissage par renforcement profond (DRL) capable de suivre des points de contact arbitraires sur un robot quadrupède, décrite dans un article arXiv (2509.17582v2, version révisée). Plutôt que d'apprendre une politique de bout en bout spécifique à chaque tâche, les auteurs proposent une architecture hiérarchique modulaire où cette unique politique de suivi de contacts sert d'interface entre un planificateur de haut niveau et le contrôle bas niveau du robot. Le système a été testé sur un large éventail de tâches de locomotion et de manipulation avec une seule politique généraliste : différentes allures, franchissement de terrains complexes comme des escaliers et des pentes, traversée de pierres de gué et de poutres étroites jamais vues à l'entraînement, ainsi que des interactions physiques comme appuyer sur un bouton ou pousser un tonneau. L'intérêt principal pour l'industrie robotique tient à la promesse de rompre avec le goulot d'étranglement classique du RL en locomotion quadrupède : la définition et l'ajustement itératifs de fonctions de récompense pour chaque nouvelle application, un processus chronophage qui limite le passage à l'échelle. En stabilisant l'exécution des contacts malgré l'incertitude dynamique et les erreurs de planification, GeCCo permet d'échanger ou de composer des planificateurs (codés à la main, appris ou basés sur de l'optimisation) sans réentraîner la couche de contrôle. Pour des intégrateurs cherchant à combiner locomotion et manipulation sur une même plateforme, cela suggère la possibilité de construire de nouveaux comportements en assemblant un planificateur spécifique à la tâche avec une politique pré-entraînée générique, plutôt qu'en repartant de zéro à chaque fois. L'article se positionne face aux méthodes dominantes de RL end-to-end en locomotion quadrupède, qu'il cherche explicitement à dépasser en généralité et en modularité. Aucune affiliation industrielle ni partenaire commercial n'est mentionné dans le résumé, ce qui situe ce travail comme une contribution de recherche plutôt qu'une annonce produit. Des démonstrations vidéo sont disponibles sur le site du projet, vassil-atn.github.io/gecco.github.io, mais l'article ne précise ni feuille de route de déploiement ni pilote industriel annoncé.

RecherchePaper
1 source