
Un nouveau cadre améliore de 15 % le suivi de trajectoire des robots volants et marcheurs
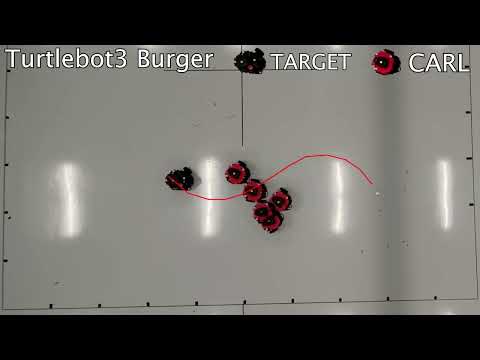
Des chercheurs de l'Université de l'Illinois à Urbana-Champaign ont mis au point une méthode d'apprentissage baptisée CARL (Contraction-Aware Reinforcement Learning), qui associe apprentissage par renforcement et théorie de la contraction. Elle vise à améliorer le suivi de trajectoire tout en offrant des garanties mathématiques de stabilité. Les équipes l'ont testée sur trois plateformes aux dynamiques très différentes : un robot à roues TurtleBot 3 Burger (l'article le nomme « TurboBot 3 Burger »), un drone à ailes battantes et un hexapode Jethexa. Elles annoncent un gain de précision de suivi allant jusqu'à 15 % par rapport aux méthodes existantes. Les essais ont d'abord eu lieu en simulation, puis sur des machines réelles dans un laboratoire de vol du département d'ingénierie aérospatiale. Les résultats sont présentés comme valables dans les deux cas. En revanche, l'article ne précise ni les méthodes de référence, ni le nombre d'essais, ni la répartition du gain entre les trois robots. Le « jusqu'à 15 % » est donc un maximum, pas une moyenne.
Le problème visé est connu. Une politique apprise par renforcement peut accomplir sa tâche tout en se comportant de façon imprévisible ou en s'écartant fortement de la trajectoire voulue, ce qui est difficilement acceptable sur du matériel coûteux ou au contact de personnes. CARL garde l'apprentissage par renforcement comme contrôleur principal. La théorie de la contraction, un cadre d'analyse de la stabilité des systèmes dynamiques, sert à borner la croissance des erreurs de suivi. De petites erreurs subsistent, mais leur amplitude est mathématiquement limitée. Pour un intégrateur ou un responsable sécurité, c'est la différence entre une politique « qui marche en moyenne » et une politique dont on peut documenter l'enveloppe de comportement, un argument utile pour la certification. Les chercheurs affirment aussi que la méthode gère mieux le sim-to-real gap, par exemple un robot simulé à 1 kg qui pèse 1,2 kg en réalité. Il faut toutefois rester prudent : des plateformes de recherche de petite taille, testées en laboratoire, ne disent rien de la tenue de la méthode sur un humanoïde ou un bras industriel sous charge.
Ce travail s'inscrit dans un courant qui cherche à réconcilier l'apprentissage, performant mais opaque, et l'automatique classique, moins flexible mais vérifiable. Il se distingue des approches dominantes dans l'humanoïde et la manipulation, qui misent surtout sur des modèles VLA ou de grandes politiques entraînées en simulation et validées empiriquement, sans borne formelle sur les erreurs. Les auteurs citent la gestion des feux de forêt comme application possible : des robots déployés en environnement dangereux pour localiser des foyers et collecter des données. Il s'agit d'une piste, sans pilote ni calendrier annoncé. CARL reste à ce stade un résultat académique, non un produit. Les prochaines étapes à surveiller sont le passage à des systèmes plus complexes, à plus de degrés de liberté, et la comparaison publique avec les contrôleurs appris existants sur des benchmarks communs.
Pas d\'impact direct sur la France/UE


