
Aller au contenu principal
Questions-réponses : le record de distance du rover Perseverance sur Mars
RechercheIEEE Spectrum Robotics 

Questions-réponses : le record de distance du rover Perseverance sur Mars
1 source couvre ce sujet·Source originale ↗·
Résumé IASource uniqueImpact UE
Questions-réponses : le record de distance du rover Perseverance sur Mars
▶ Voir sur YouTube

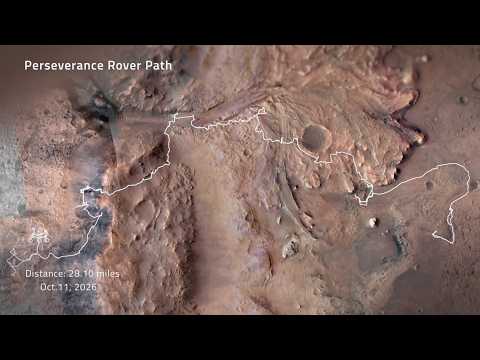
Le 11 octobre, le rover Perseverance de la NASA a bouclé un trajet portant sa distance totale parcourue sur Mars à 45,22 kilomètres (28,10 miles). Il dépasse ainsi Opportunity, qui détenait le record avec 45,16 kilomètres, soit un écart d'à peine 60 mètres. Perseverance a atterri le 18 février 2021 avec l'hélicoptère Ingenuity, environ cinq ans avant ce jalon. Mark Maimone, chef adjoint des opérations robotiques de la mission au Jet Propulsion Laboratory, attribue ce résultat avant tout à l'autonomie de conduite, avec en complément des roues renforcées. Selon lui, Perseverance conduit seul environ 90 % du temps. Spirit en était à 23 %, tandis qu'Opportunity et Curiosity plafonnaient autour de 5 %. Le rover embarque un second processeur doté d'un FPGA, dédié au traitement d'images. Un exemple daté du 10 décembre 2025 (sol 1709) montre un trajet de 246 mètres le long du bord du cratère Jezero en 2 h 35, reconstruit à partir de 53 paires d'images Navcam.

L'intérêt dépasse la statistique. Le gain de distance ne vient pas d'un meilleur matériel roulant seulement, mais d'un logiciel qui comprend le terrain, planifie une trajectoire sûre et l'exécute sans attendre un opérateur situé à 225 millions de kilomètres, avec les délais de communication que cela implique. C'est un cas rare de navigation autonome validée sur la durée dans un environnement non structuré, sans possibilité d'intervention physique. Pour les ingénieurs robotique, c'est une preuve de fiabilité à relativiser : le chiffre de 90 % vient de l'un des concepteurs du système, la marge sur le record est mince, et la conduite martienne reste lente, avec des contraintes très différentes de celles d'un entrepôt ou d'un site industriel. La leçon transposable est architecturale : calcul dédié à la perception, autonomie conçue dès l'origine plutôt qu'ajoutée, et montée en confiance progressive.

Cette progression s'étale sur près de trois décennies, et Maimone en a conçu une grande partie. Sojourner, en 1997, évitait les gros obstacles grâce à quatre lignes laser mesurant la hauteur de 20 points du terrain, avec un processeur de moins d'un mégahertz. Spirit et Opportunity, atterris en 2004, utilisaient des paires stéréo de 256 x 256 pixels. Spirit a conduit seul 23 % du temps et gagné environ 50 % de vitesse effective grâce à ce mode. Opportunity, prévu pour trois mois, a roulé quinze ans avant qu'une tempête de poussière planétaire ne l'arrête en février 2019 dans la vallée de la Persévérance. Curiosity, sur Mars depuis 2012, reste actif et partage avec Perseverance un générateur thermoélectrique à radioisotope plutôt que des panneaux solaires. Perseverance continue d'explorer la bordure de Jezero, et son logiciel d'autonomie est mis à jour régulièrement depuis cinq ans. L'extrait disponible ne détaille pas les prochains objectifs de la mission.

Impact France/UE

Pas d\'impact direct sur la France/UE

À lire aussi

Perseverance de la NASA bat son record de 45 km parcourus sur Mars grâce à la navigation autonome
1Interesting Engineering 

Perseverance de la NASA bat son record de 45 km parcourus sur Mars grâce à la navigation autonome

Le rover Perseverance de la NASA a établi un nouveau record de distance parcourue par un véhicule sur un autre monde : 28,10 miles (45,22 km) au compteur sur Mars, contre 28,06 miles (45,16 km) pour Opportunity, qui détenait la marque depuis des années. Le seuil a été franchi le 11 octobre, au 2 006e jour martien de la mission, lors d'un trajet de 91,31 mètres. Le rover à six roues y est parvenu en environ cinq ans et demi, contre près de quinze ans pour Opportunity. Ce rythme tient à AutoNav, son système de navigation autonome, qui a piloté plus de 90 % de la distance totale, contre environ 5 % pour le système embarqué d'Opportunity. AutoNav photographie le terrain, construit une carte 3D des dangers et choisit un itinéraire sûr entre des points de passage fixés par les ingénieurs sur Terre. Il traite environ 600 000 points de mesure à chaque observation, contre 20 pour Sojourner, et permet de parcourir jusqu'à 412 mètres en un sol (jour martien). Pour la robotique mobile, le résultat vaut surtout comme preuve d'autonomie en conditions réelles. Un véhicule qui décide seul de sa trajectoire, sans attendre de commandes détaillées avec un délai de communication de plusieurs minutes, a produit 90 % de son kilométrage sur une durée de plusieurs années. C'est la démonstration à grande échelle d'une perception et d'une planification embarquées fiables, dans un environnement sans GPS, sans infrastructure et sans possibilité d'intervention physique. Il faut toutefois relativiser la comparaison avec Opportunity : la distance dépend aussi du terrain, de la stratégie scientifique et de la puissance de calcul disponible, pas seulement de la qualité de l'algorithme. Pour les intégrateurs et les industriels, l'intérêt tient à la fiabilité sur la durée : Steven Lee, du Jet Propulsion Laboratory, indique que tous les systèmes de mobilité fonctionnent et que les tests de durée de vie étendue sont favorables, ce qui laisse prévoir de nouveaux records pendant de nombreuses années. La mission initiale prévoyait au maximum 12,4 miles de conduite, un plafond déjà largement dépassé. La NASA vient d'approuver une première extension, entamée en octobre et qui court jusqu'à environ fin 2028, consacrée au bord du cratère Jezero. Perseverance traverse actuellement la zone de Lac de Charmes en direction d'Idubi, où les scientifiques cherchent des traces d'anciens systèmes hydrothermaux, puis il doit poursuivre vers le sud jusqu'à Rainbow Falls, un bloc de croûte ancienne de 100 mètres de large exposé par l'impact qui a créé le cratère. Il a prélevé 29 échantillons de roches et de sol, et a identifié dans la roche Cheyava Falls un possible biosignal, qui ne constitue pas une preuve de vie passée. Les rovers précédents fixent le repère : Sojourner a parcouru environ 100 mètres, Spirit 7,7 km et Curiosity plus de 38 km, tandis que Perseverance a aussi dépassé le rover lunaire d'Apollo 17 et Lunokhod 2. La NASA améliore son logiciel pour réduire les corrections de direction inutiles et permettre au rover de se localiser avec des cartes orbitales pendant qu'il roule, afin d'allonger les journées de conduite.

RecherchePaper
1 source
Persistance des connaissances spatio-temporelles : un graphe pour la mémoire de scène des robots dans les questions-réponses
2arXiv cs.RO 

Persistance des connaissances spatio-temporelles : un graphe pour la mémoire de scène des robots dans les questions-réponses

Des chercheurs publient VL-KnG, un framework open, sans entraînement supplémentaire ("training-free"), qui construit des graphes de connaissances spatio-temporels à partir de vidéo égocentrique monoculaire pour répondre à des questions embarquées (embodied question answering). Le système traite la vidéo par blocs (chunks) et maintient l'identité persistante des objets grâce à une association spatio-temporelle pilotée par un grand modèle de langage, baptisée STOA. Les réponses sont générées via une méthode nommée Graph-Enhanced Retrieval (GER), qui combine récupération de sous-graphes et ancrage visuel. Le framework a été évalué sur trois bancs d'essai : OpenEQA, NaVQA, et un nouveau benchmark introduit par les auteurs, WalkieKnowledge. Les auteurs annoncent une précision compétitive face aux VLM (vision-language models) de pointe, une latence de requête nettement plus faible, et un raisonnement explicable car ancré dans le graphe. Une démonstration sur robot réel est mentionnée, montrant une latence stable même quand l'historique d'observation s'allonge. Il s'agit de la troisième version (v3) d'un article déjà publié sur arXiv, donc d'un travail académique révisé, pas d'un produit commercial. L'intérêt principal ici n'est pas robotique au sens matériel, mais architectural : les VLM actuels n'ont pas de mémoire persistante, donc chaque nouvelle question oblige à retraiter toutes les frames vidéo échantillonnées, ce qui rend le coût de calcul proportionnel à la longueur de la vidéo. En découplant la latence de requête de la durée d'observation, VL-KnG répond directement à un vrai goulot d'étranglement pour les agents embarqués qui doivent accumuler de l'expérience sur de longues sessions, un problème central pour tout robot ou assistant devant raisonner sur des heures d'historique plutôt que sur un clip court. Si les chiffres de latence et de précision se confirment en dehors des bancs d'essai propriétaires des auteurs, cela offre une alternative crédible aux approches de reconstruction 3D lourdes, sans nécessiter cette reconstruction. Le papier s'inscrit dans une lignée de travaux sur la mémoire de scène persistante pour l'IA embarquée, en concurrence directe avec les approches de VLM "frontière" et les baselines à représentation persistante existantes, qu'il dit surpasser sur plusieurs configurations. Aucun acteur français ou européen n'est cité dans ce travail. Les prochaines étapes attendues concernent la généralisation à des environnements plus larges et l'intégration comme substrat mémoire pour des agents robotiques devant mettre à jour leurs connaissances en continu.

RecherchePaper
1 source
IA incarnée multi-agents : allocation de puissance centrée sur la mémoire pour la réponse aux questions
3arXiv cs.RO 

IA incarnée multi-agents : allocation de puissance centrée sur la mémoire pour la réponse aux questions

Une équipe de chercheurs a publié sur arXiv (arXiv:2604.17810) un travail portant sur la question-réponse incarnée multi-agents (MA-EQA), un paradigme où plusieurs robots coopèrent pour répondre à des requêtes sur ce qu'ils ont collectivement observé sur un horizon temporel long. Le problème central est l'allocation de puissance de transmission entre agents : quand les ressources radio sont limitées, quels robots doivent avoir la priorité pour transmettre leurs souvenirs ? Les auteurs proposent deux contributions : un modèle de qualité de mémoire (QoM) basé sur un examen génératif adversarial (GAE), et un algorithme d'allocation de puissance centré sur la mémoire (MCPA). Le GAE fonctionne par simulation prospective : il génère des questions-tests, évalue la capacité de chaque agent à y répondre correctement à partir de sa mémoire locale, puis convertit les scores obtenus en valeurs QoM. Le MCPA maximise ensuite la fonction QoM globale sous contraintes de ressources de communication. L'analyse asymptotique montre que la puissance allouée à chaque robot est proportionnelle à sa probabilité d'erreur GAE, ce qui revient à prioriser les agents dont la mémoire est la plus riche et la plus fiable. L'intérêt concret pour les architectes de systèmes multi-robots est de déplacer le critère d'optimisation réseau des métriques classiques (débit, latence, taux d'erreur paquet) vers une métrique applicative directement liée à la tâche cognitive. Dans les déploiements d'inspection industrielle, de surveillance ou d'exploration, les robots ne transmettent pas pour transmettre : ils transmettent pour que le système réponde correctement à des requêtes. Traiter la qualité de mémoire comme une ressource à optimiser, au même titre que la bande passante, est une rupture de cadre qui pourrait influencer la conception des protocoles MAC dans les flottes d'agents embarqués. Les expériences montrent des gains significatifs sur plusieurs benchmarks et scénarios, bien que les conditions exactes de déploiement (nombre d'agents, topologie réseau, type de mémoire) ne soient pas détaillées dans le résumé. Ce travail s'inscrit dans la convergence entre vision-langage-action (VLA), robotique incarnée et gestion des ressources sans-fil, un champ en forte expansion depuis 2023 avec les architectures de type RT-2 (Google DeepMind), GR00T (NVIDIA) et les travaux sur les mémoires épisodiques longue durée pour robots mobiles. Sur le plan académique, le GAE adversarial rappelle les techniques d'évaluation automatique utilisées dans les LLM, ici transposées à l'évaluation de mémoire sensorimotrice. Les prochaines étapes logiques seraient une validation sur flotte physique réelle et une intégration avec des architectures mémoire de type VectorDB embarqué. Aucun acteur industriel ni partenaire de déploiement n'est mentionné dans la publication.

RecherchePaper
1 source
Preuves d'interaction ancrées sur l'instance : ancrer les plans du robot dans les gestes de désignation et de manipulation humains
4arXiv cs.RO 

Preuves d'interaction ancrées sur l'instance : ancrer les plans du robot dans les gestes de désignation et de manipulation humains

Des chercheurs proposent l'« instance-anchored interaction évidence » (IAE), une méthode qui permet à un robot d'agir sur ce qu'une personne a montré plutôt que dit : quel carton, parmi plusieurs identiques, a été désigné du doigt, ou quelle boîte a été manipulée. Le défaut à corriger est que le plan s'exécute à partir de la scène finale, alors que l'indice survient plus tôt, parfois sur des objets qui ont bougé depuis. L'IAE associe chaque objet de la scène finale à un identifiant public, conserve son identité tout au long de la vidéo par propagation arrière de masques, puis décrit chaque image par la géométrie entre mains, avant-bras et instances. Un réseau d'évidence, entraîné uniquement à partir des résultats des tâches, note les instances. Pour le pointage, un programme dynamique contraint par une grammaire, entraîné avec une perte structurée, décode des programmes objet-destination. Des programmes symboliques, sans apprentissage, traitent la désambiguïsation des références et les tâches épisodiques. Sur 1 255 requêtes du benchmark WatchAct, évaluées par exécution symbolique, l'IAE atteint 64,2 % de succès de plan sur les tâches à intention implicite, contre 27,5 % pour un modèle vision-langage de 32 milliards de paramètres (succès strict : 49,7 % contre 15,4 %). Sur la restauration, l'inversion et l'imitation, sans entraînement spécifique, elle obtient 46,4 % contre 27,0 %. Ces chiffres montrent que l'écart ne vient pas d'une meilleure perception brute, mais de la manière dont l'information est structurée. Les auteurs ont testé des contrôles avec les mêmes surcouches de perception, les mêmes 32 images, un suivi vers l'avant, ou un modèle de relations entraîné sur les mêmes étiquettes. Aucun n'explique le gain. Lorsque le même modèle de langage reçoit l'évidence de l'IAE sous forme de texte, avec sa signification expliquée, il monte à 57,4 %. L'essentiel du bénéfice vient donc de l'ancrage des preuves sur les instances, et les programmes explicites ajoutent 6,8 points à un coût bien moindre. Pour les intégrateurs et les équipes qui déploient des robots d'assistance en logistique ou en collaboration homme-robot, c'est un argument en faveur d'architectures hybrides (perception structurée plus exécution symbolique) plutôt que d'un grand modèle généraliste alimenté par des images brutes. Le pointage reste toutefois le cas le plus difficile, avec seulement 16,9 % de succès strict, ce qui rend la méthode inadaptée à un déploiement sans supervision pour ce type d'interaction. Il s'agit en outre d'un résultat de benchmark en laboratoire, et non d'un déploiement réel. Ce travail s'inscrit dans l'effort de rendre les modèles vision-langage-action et les planificateurs fondés sur des VLM capables de comprendre l'intention humaine dans des scènes encombrées, où l'identité des objets se perd quand ils sont déplacés. Les modèles généralistes de 32 milliards de paramètres restent la référence comparée ici, et leur faiblesse sur les objets identiques est mise en évidence. La publication est un preprint arXiv (v1), non évalué par des pairs, et le code est disponible sur GitHub (WeiZhou96/iae-watchact). Aucun calendrier de pilote industriel n'est annoncé. Les prochaines étapes probables concernent l'amélioration du pointage et la validation sur des robots réels, au-delà de l'évaluation par exécution symbolique.

RecherchePaper
1 source