
Aller au contenu principal
RecherchearXiv cs.RO 

DAMP : locomotion humanoïde par apprentissage de croyance débruitée et a priori de mouvement adverses
1 source couvre ce sujet·Source originale ↗·
Résumé IASource uniqueImpact UE
DAMP : locomotion humanoïde par apprentissage de croyance débruitée et a priori de mouvement adverses
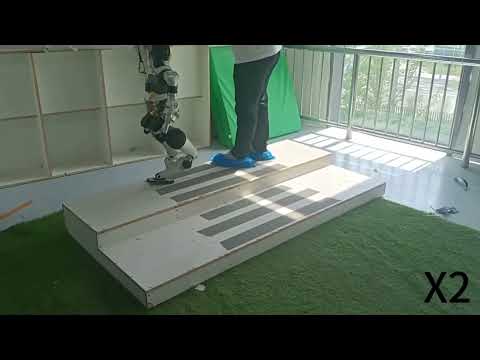
▶ Voir sur YouTube

Des chercheurs publient sur arXiv (2610.11505) DAMP, un cadre d'apprentissage par renforcement conçu pour la locomotion de robots humanoïdes sur terrains difficiles, sans aucune information perçue : ni caméra, ni lidar, ni carte de hauteur. Le système repose sur des réseaux de neurones récurrents qui exploitent les dépendances temporelles pour inférer de façon implicite l'information dite privilégiée (celle dont dispose le simulateur mais pas le robot réel) ainsi que d'autres variables latentes utiles à la tâche. Les représentations apprises sont alignées sur l'objectif de la tâche, ce qui doit produire une politique robuste et cohérente avec le but visé. Le titre indique aussi l'emploi de « denoised belief learning », c'est-à-dire un état de croyance débruité, et d'« adversarial motion priors », des a priori de mouvement adversariaux qui poussent la démarche vers un style naturel. L'ensemble est entraîné de bout en bout puis transféré de la simulation au monde réel. Les auteurs annoncent une démonstration sur robot physique, disponible en vidéo. Le résumé ne donne ni plateforme, ni chiffres de performance, ni description des terrains testés.

L'intérêt tient à l'hypothèse de départ. Beaucoup de contrôleurs de marche humanoïde récents s'appuient sur la perception extéroceptive pour franchir marches, pentes et obstacles, ce qui ajoute des capteurs, de la latence et des modes de défaillance : occlusions, poussière, éclairage, calibration. Une politique aveugle, qui déduit le terrain de la seule proprioception et de l'historique des mouvements, offrirait une couche de repli fiable et moins coûteuse pour des machines destinées à des sites industriels ou logistiques. Elle illustre aussi une tendance de fond de la recherche : distiller dans une politique déployable le savoir du simulateur, un schéma enseignant-élève rendu plus propre par la mémoire récurrente. Il faut toutefois rester prudent. Il s'agit d'un préprint, sans évaluation indépendante, et une vidéo de démonstration ne renseigne ni sur le taux de réussite, ni sur la sévérité des terrains, ni sur la reproductibilité. La notion de « terrain complexe » n'est pas chiffrée dans le texte disponible.

Ce travail s'inscrit dans une lignée bien établie. Les politiques de locomotion aveugles entraînées par RL et transférées de la simulation au réel se sont imposées sur les quadrupèdes, avec l'apprentissage de type enseignant-élève popularisé autour de l'ETH Zurich. Les adversarial motion priors, issus de l'animation de personnages, servent à obtenir des allures plus humaines sans réécrire à la main les fonctions de récompense. Côté humanoïdes, les acteurs industriels (Figure, Tesla avec Optimus, Agility Robotics, Unitree, Boston Dynamics) combinent de plus en plus RL en simulation et perception, tandis que des acteurs européens comme Wandercraft ou Enchanted Tools travaillent aussi sur la marche robuste. Reste à savoir si DAMP sera accompagné d'un code ouvert, de comparaisons chiffrées avec des méthodes de référence et de tests sur plusieurs morphologies, éléments qui permettront de juger sa portée réelle.

Impact France/UE

Pas d\'impact direct sur la France/UE

À lire aussi

Apprentissage des mouvements de patinage à roulettes pour robots humanoïdes via des priorités de mouvement adverses
1arXiv cs.RO 

Apprentissage des mouvements de patinage à roulettes pour robots humanoïdes via des priorités de mouvement adverses

Des chercheurs présentent, dans un article déposé le 14 juillet 2026 sur arXiv (2607.10815), une méthode d'apprentissage par renforcement pour faire patiner un robot humanoïde en rollers. Le système s'appuie sur les Adversarial Motion Priors (AMP), une technique qui entraîne une politique de contrôle à imiter des mouvements de référence tout en respectant les contraintes physiques du robot. Deux allures distinctes sont visées : le Pump Glide (une godille d'impulsion) et le Push Glide (une poussée alternée classique du patinage). Pour chacune, les auteurs ont capturé des données de mouvement humain par motion capture, puis les ont retargetées, c'est-à-dire adaptées à la morphologie du robot humanoïde, avant de les lisser et de les rééchantillonner en états de référence exploitables pour l'entraînement AMP. Les deux allures sont apprises séparément, avec des jeux de données, des politiques et des architectures de récompense entièrement indépendants. Des expériences en simulation évaluent la qualité du geste, le suivi de vitesse, la capacité à tourner et l'apport de chaque composante de récompense via des ablations. L'enjeu dépasse l'anecdote du robot à roulettes : patiner impose de gérer simultanément l'équilibre corps entier, des contacts roulants à faible frottement et une posture qui varie avec la vitesse, un problème de contrôle nettement plus contraint que la marche ou la course déjà démontrées sur humanoïdes. Réussir ce type de locomotion en simulation valide la robustesse des pipelines AMP pour des dynamiques de contact inhabituelles, un signal utile pour les équipes qui explorent des locomotions non conventionnelles (patins, skis, roues) au-delà des gaits bipèdes standards. Cela reste toutefois un résultat de simulation, sans transfert annoncé vers un robot physique ni précision sur la plateforme matérielle visée. Les méthodes AMP, popularisées dans l'animation de personnages puis reprises en robotique pour générer des démarches naturelles et stables, connaissent depuis deux ans une adoption croissante dans le contrôle d'humanoïdes, portée par des laboratoires travaillant sur la locomotion bipède avancée. Cet article s'inscrit dans cette lignée en repoussant le champ d'application vers des gaits hybrides homme-machine inédits. Les auteurs ne mentionnent pas de calendrier de validation sur robot réel ni de partenaire industriel associé à ces travaux.

RecherchePaper
1 source
Apprentissage de priors moteurs hybrides réutilisables pour la locomotion humanoïde par imitation de mouvement
2arXiv cs.RO 

Apprentissage de priors moteurs hybrides réutilisables pour la locomotion humanoïde par imitation de mouvement

Une équipe de recherche propose un pipeline en trois étapes pour transformer l'imitation de mouvement humain en un "hybrid motion prior" (HMP) réutilisable pour la locomotion humanoïde. D'abord, une politique experte est entraînée par apprentissage par renforcement à imiter des séquences de motion capture humaine retargetées sur un squelette robotique. Cette expertise est ensuite distillée dans une architecture figée composée d'un encodeur proprioceptif, d'un codebook RVQ (residual vector-quantized) et d'un décodeur d'actions. Enfin, des politiques spécifiques à chaque tâche sont entraînées à sélectionner des entrées discrètes de ce codebook, sans jamais réentraîner le HMP sous-jacent. La méthode est évaluée en simulation sur trois tâches : suivi de vitesse, navigation vers un point cible, et récupération de chute avec suivi de vitesse. La politique de suivi de vitesse a ensuite été déployée sur un robot réel, un Unitree G1. Les chercheurs montrent aussi qu'entraîner le codebook avec un "rotation trick" plutôt qu'un estimateur straight-through classique améliore l'organisation de l'espace latent et réduit le nombre de chutes en aval. L'intérêt principal tient à la réutilisabilité : au lieu d'entraîner une politique RL distincte par tâche avec sa propre fonction de récompense, un seul module d'action reste figé et sert d'interface commune à plusieurs politiques de haut niveau. Cela répond à une limite connue de l'imitation de mouvement, dont les contrôleurs restent généralement de simples "suiveurs" de référence, inutilisables tels quels pour résoudre une tâche. Le codebook obtenu s'avère aussi interprétable : le nombre d'étages RVQ actifs module directement les types de démarche disponibles, un signal utile pour du contrôle hiérarchique. Pour les équipes qui construisent des piles logicielles humanoïdes, cette approche s'inscrit dans la même logique que les bibliothèques de compétences motrices low-level découplées des politiques de tâche, un principe partagé par des modèles VLA comme Pi-0, GR00T N2 ou Helix, même si ceux-ci ciblent surtout la manipulation. Ce travail s'inscrit dans la lignée des méthodes d'imitation de mouvement pour humanoïdes (type DeepMimic, ASE) qui cherchent depuis plusieurs années à extraire des priors moteurs génériques à partir de données de capture humaine. Le déploiement reste toutefois limité à un seul robot et une seule tâche testée en réel, la navigation et la récupération de chute n'ayant été validées qu'en simulation. Les auteurs présentent cela comme une brique réutilisable, ouvrant la voie à d'autres politiques de tâche construites sur le même HMP sans nouveau cycle d'entraînement complet.

RecherchePaper
1 source
HuMBLE : apprentissage de comportements guidé par le mouvement humain pour la locomotion incarnée
3arXiv cs.RO 

HuMBLE : apprentissage de comportements guidé par le mouvement humain pour la locomotion incarnée

Des chercheurs ont publié sur arXiv (référence 2610.10489) HuMBLE, un cadre d'apprentissage qui produit des politiques de locomotion humanoïde pilotables en temps réel, robustes et fidèles à la démarche humaine. Les auteurs partent d'un jeu de données de locomotion humaine constitué en interne, couvrant plusieurs vitesses et directions. Ils entraînent d'abord par apprentissage par renforcement (RL) une politique « enseignante » conditionnée par une référence corps entier. Cette politique est ensuite distillée en une politique « a priori » légère, qui ne reçoit que la proprioception et une commande de pilotage plane (vitesse du torse). Une seconde phase affine cette politique par RL multi-tâches. Une tâche conditionnée par un objectif suit des commandes arbitraires, y compris hors de la distribution des données. Une tâche guidée par référence suit les mouvements humains et sert de régularisateur de style. Le cadre est validé sur trois robots : Atlas R1 et Atlas D1 de Boston Dynamics, et le Unitree G1. Les tests incluent le pilotage direct par un utilisateur en intérieur et en extérieur, ainsi que l'intégration comme couche de locomotion dans des architectures de contrôle hiérarchiques. L'article ne donne dans son résumé ni taux de réussite, ni vitesses maximales, ni durée de test. L'enjeu est un compromis connu en locomotion humanoïde. Les contrôleurs optimisés pour le suivi de commande et la robustesse produisent des démarches mécaniques, souvent peu naturelles et énergétiquement discutables. Ceux calés sur des données de mouvement humain se généralisent mal dès que la commande sort du domaine des données. HuMBLE vise à tenir les deux bouts avec une politique légère, déployable à bord, qui reconstruit un mouvement corps entier coordonné à partir d'une simple commande de direction et de vitesse. Pour les intégrateurs, cette interface compte. Une couche de locomotion pilotable par un planificateur de haut niveau, VLA ou téléopération, s'insère plus facilement dans une pile existante. Le test sur deux morphologies Atlas et sur le G1, un robot d'entrée de gamme très répandu en recherche, suggère aussi une certaine portabilité entre plateformes. Il faut toutefois rester prudent. Il s'agit d'un préprint non évalué par les pairs. Le jeu de données est interne et non décrit en détail, et les comparaisons annoncées portent sur des politiques RL « tabula rasa » plutôt que sur d'autres méthodes d'imitation de mouvement. Ce travail s'inscrit dans une série de méthodes qui injectent des données de mouvement humain dans l'apprentissage de la locomotion, des approches de type imitation adversariale (AMP) au suivi de mouvement par RL. Le retargeting de mouvements humains sur humanoïdes est devenu un levier courant, notamment pour rendre les démarches plus naturelles et plus lisibles pour les humains travaillant à proximité des robots. La présence d'Atlas, dont la version électrique est au cœur de la stratégie humanoïde de Boston Dynamics, indique un travail proche de l'industrie, sans que le résumé ne précise les auteurs ni leur affiliation. Côté concurrence, de nombreux laboratoires et entreprises, dont Unitree, Figure, Tesla et Agility, cherchent aussi à combiner naturel du mouvement et robustesse. La suite probable, sans calendrier annoncé, passe par des évaluations plus larges et par l'intégration avec des modèles de haut niveau.

UEPas d\'impact direct sur la France/UE

RecherchePaper
1 source
ADP : a priori dynamiques adverses pour une locomotion humanoïde ancrée physiquement
4arXiv cs.RO 

ADP : a priori dynamiques adverses pour une locomotion humanoïde ancrée physiquement

Des chercheurs publient sur arXiv (arXiv:2607.03454) une nouvelle méthode d'apprentissage baptisée Adversarial Dynamics Priors (ADP), destinée a rendre la marche des robots humanoïdes plus résistante aux chocs et poussées extérieures. Les approches actuelles de type AMP (Adversarial Motion Priors) imposent un style de démarche naturel en imitant des caractéristiques cinématiques du mouvement, mais elles ne regulent pas directement les grandeurs dynamiques sous jacentes: trajectoire du centre de masse, moment centroidal, forces de contact et états de contact au sol. ADP change la cible de l'apprentissage adversarial en remplaçant ces indices de style par des trajectoires générées via optimisation de trajectoire, utilisées comme jeu de référence. Un discriminateur est ensuite entraine a juger si les séquences temporelles produites par la politique de contrôle du robot restent cohérentes avec cette distribution de référence, sans suivi explicite de mouvement imprime a l'avance. Compare a AMP, la référence la plus solide testée, ADP améliore de 16,7% le seuil de réussite a 80% face a une impulsion (J80, une mesure de la force de choc absorbable sans chute), tout en réduisant de 47,9% le temps de récupération moyen et de 35,4% l'erreur de suivi de vitesse après perturbation. Pour l'industrie robotique, ce travail cible un angle mort fréquent des démonstrations commerciales: la résilience a des perturbations réelles et non scriptées, plutôt que la seule fluidité du mouvement en conditions de laboratoire. Les contrôleurs entraines par imitation de style de mouvement produisent souvent des démarches visuellement convaincantes en vidéo mais fragiles des qu'un choc imprévu survient, un écart classique entre démonstration et déploiement réel évoque régulièrement dans le secteur des humanoïdes. En régulant directement la dynamique plutôt que l'apparence du mouvement, ADP fournit une piste concrète pour combler cet écart, un enjeu direct pour les intégrateurs qui envisagent des humanoïdes en environnements industriels non contrôles. Ce travail s'inscrit dans la lignée des méthodes d'apprentissage par imitation adversariale de mouvement (AMP), largement adoptées depuis plusieurs années pour entrainer des politiques de contrôle de robots bipèdes et quadrupèdes en simulation avant transfert au réel. Il ne s'accompagne pas, a ce stade, d'annonce de déploiement sur une plateforme commerciale identifiée: il s'agit d'une contribution de recherche méthodologique, évaluée en simulation, dont la généralisation a du matériel physique reste a démontrer dans de futurs travaux.

RecherchePaper
1 source