
Apprendre de nouveaux tours à un chien robot : compétences variées de quadrupède par apprentissage par renforcement et par imitation combinés, avec sélection adverse des tâches
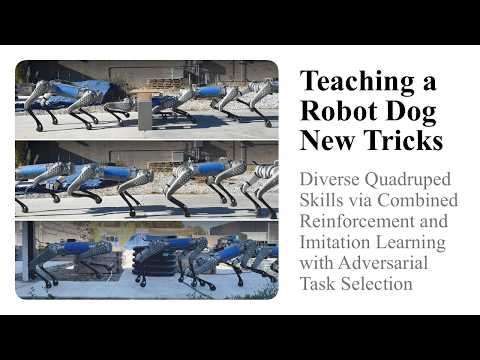
Des chercheurs proposent une méthode en trois étapes pour entraîner une politique unique de locomotion et de manipulation capable d'exécuter 22 tâches distinctes sur un robot quadrupède, à partir de 8 politiques « enseignantes » spécialisées. Dans un premier temps, chaque enseignant est entraîné par apprentissage par renforcement (RL) sur une tâche étroitement définie : marche, creusement, saut, etc. Deux étapes supplémentaires distillent ensuite ces compétences dans une politique « élève », avec un objectif combinant RL et apprentissage par imitation (IL). Un mécanisme de sélection adverse des tâches concentre l'entraînement sur la tâche où l'élève est le moins performant. La politique obtenue sait aussi composer des comportements inédits, comme ramper, à partir des compétences de base. Le résultat a été déployé sur un Unitree B1, un quadrupède du commerce, ce qui constitue la partie « monde réel » de l'évaluation. L'étude, publiée sur arXiv (v1), est une preuve de concept académique et non un produit.
L'enjeu tient à un verrou connu de la robotique à pattes : le RL réussit bien sur une tâche isolée, mais les applications visées, comme la robotique agricole ou l'exploration spatiale, exigent un répertoire varié (se déplacer, creuser, inspecter de près). L'apprentissage multitâche de bout en bout souffre d'une faible efficacité en échantillons et de conflits de gradients entre tâches, où l'amélioration de l'une dégrade les autres. Selon les auteurs, leur méthode préserve mieux la qualité du mouvement et suit plus précisément les commandes que deux références : un PPO multitâche classique et une approche « distiller puis affiner ». Elle généraliserait même parfois à des tâches jamais entraînées explicitement. Ces affirmations viennent de l'article lui-même. Les résultats chiffrés, la taille des écarts et la part de l'évaluation réalisée en simulation plutôt que sur le B1 ne figurent pas dans le résumé et restent à vérifier. Pour un intégrateur, l'intérêt est de pouvoir entraîner des spécialistes séparément, puis les fusionner en un seul contrôleur, sans repartir de zéro à chaque nouvelle compétence.
Ce travail s'inscrit dans la montée en puissance de la distillation multi-enseignants et du RL en simulation pour la locomotion, après les politiques de marche robustes des dernières années. La difficulté a ensuite été d'étendre ces politiques à des comportements variés sans qu'elles s'oublient les unes les autres. Le choix du Unitree B1, plateforme répandue en recherche et en inspection industrielle, rend la reproduction plausible pour d'autres laboratoires. Les concurrents sont nombreux : les approches multitâches par RL pur, les politiques généralistes de type VLA (vision-langage-action), et les méthodes de distillation de compétences portées par plusieurs groupes académiques. Aucun pilote commercial ni calendrier n'est annoncé. Les suites probables sont des évaluations sur des terrains agricoles ou planétaires réels, et une extension à un nombre de tâches plus élevé. Une vidéo de démonstration est disponible, mais, comme souvent, elle ne dit rien du taux d'échec hors des essais présentés.
Pas d\'impact direct sur la France/UE
Dans nos dossiers


