
Aller au contenu principal
Apprendre de l'humain pour une assistance proactive dans le transport collaboratif homme-robot
RecherchearXiv cs.RO 

Apprendre de l'humain pour une assistance proactive dans le transport collaboratif homme-robot
1 source couvre ce sujet·Source originale ↗·
Résumé IASource uniqueImpact UE
Apprendre de l'humain pour une assistance proactive dans le transport collaboratif homme-robot
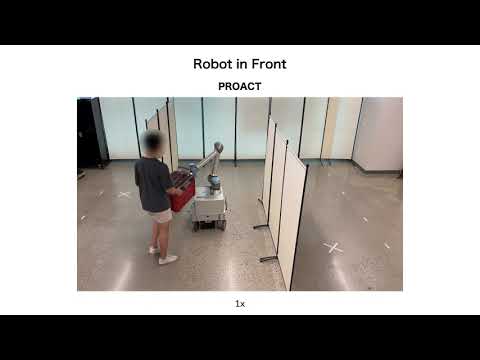
▶ Voir sur YouTube

Une équipe de recherche en robotique présente PROACT, un framework pour le transport collaboratif homme-robot, décrit dans un article arXiv (2609.25351v1) publié en septembre 2026. Le système combine anticipation du comportement humain et contrôle compliant du corps entier d'un robot, via une architecture transformer entraînée sur un vaste jeu de données réel de démonstrations de transport en binôme humain-humain. Ce modèle apprend à prédire le mouvement futur de l'objet transporté à partir du comportement collaboratif observé. Testé sur 108 essais réels avec un manipulateur mobile à 9 degrés de liberté, PROACT réduit le travail d'interaction moyen de 59,2% par rapport à une approche purement compliante, et de 20,4% par rapport à une commande prédictive (MPC) classique. Le temps de complétion moyen baisse de 12,9% et 6,9% respectivement face à ces deux références. Une vidéo des expériences a été mise en ligne pour illustrer les résultats.

Le transport collaboratif d'objets lourds ou encombrants reste un problème non résolu en robotique, avec des applications directes en logistique, en manufacturing et à domicile. Jusqu'ici, les approches se scindaient en deux familles incompatibles: des robots efficaces pour déplacer l'objet mais rigides face aux ajustements de l'utilisateur, ou des robots souples et réactifs mais incapables d'agir sans guidage humain constant. En démontrant qu'un seul modèle peut réduire simultanément l'effort physique perçu par l'utilisateur et le temps d'exécution, PROACT apporte une preuve empirique que l'anticipation apprise et la compliance mécanique ne sont pas mutuellement exclusives, un résultat qui intéresse directement les intégrateurs travaillant sur la cobotique industrielle et l'assistance physique.

Le travail s'inscrit dans la lignée des recherches sur le contrôle compliant et le model prédictive control appliqués à la manipulation collaborative, deux approches jusque-là traitées séparément dans la littérature. L'apport de PROACT est de fusionner ces deux paradigmes grâce à un modèle appris du comportement humain plutôt qu'à des règles ou une planification pure. L'article ne précise pas de partenariat industriel ni de calendrier de déploiement commercial: il s'agit à ce stade d'un résultat de recherche validé en environnement contrôlé, avec du matériel expérimental, et non d'un produit ou d'un pilote industriel annoncé.

Dans nos dossiers

À lire aussi

PACT : une approche proactive pour l'assistance continue aux tâches en collaboration humain-robot
1arXiv cs.RO 

PACT : une approche proactive pour l'assistance continue aux tâches en collaboration humain-robot

Des chercheurs ont publié PACT (Proactive Asking for Continual Task Assistance), un framework de collaboration humain-robot sur la durée, soumis sur arXiv en mai 2026 (arXiv:2605.24350). Le problème posé est concret : un assistant robotique déployé sur plusieurs jours ignore initialement les habitudes et préférences de son utilisateur, rendant l'inférence passive peu fiable dès les premières interactions. PACT propose une logique "ask-or-act" : plutôt que d'agir sans certitude, le robot décide à chaque instant s'il doit demander une clarification ou exécuter directement la tâche. Le système combine les observations courantes avec un historique d'interactions multi-jours pour évaluer la suffisance contextuelle avant d'agir. L'implémentation principale repose sur du reinforcement learning, et les auteurs introduisent une nouvelle métrique, la "clarification utility", qui mesure le compromis entre précision de l'assistance et fréquence des interruptions imposées à l'utilisateur. Ce framework répond à un déficit structurel des robots d'assistance actuels : en inférant silencieusement, un robot avec un modèle utilisateur incomplet accumule les erreurs et dégrade rapidement la confiance opérationnelle. PACT inverse la logique -- le robot reconnaît son incertitude et l'exprime plutôt que de la masquer. Pour les intégrateurs envisageant des robots en assistance à domicile, en co-robotique de bureau ou en environnement industriel léger, cette approche réduit la nécessité d'une modélisation préalable exhaustive des préférences utilisateur. Les expériences en scénarios multi-jours montrent des gains consistants en précision et en utilité des clarifications face aux baselines d'inférence passive, bien que la validation sur plateforme matérielle réelle reste à démontrer. Le défi de l'adaptation continue en collaboration humain-robot est partagé par plusieurs axes de recherche actifs, dont les benchmarks domestiques ALFRED et les travaux de personnalisation menés chez Figure, 1X ou Boston Dynamics pour leurs robots humanoïdes. Des équipes européennes -- INRIA, TU Delft -- explorent également ces mécanismes d'apprentissage en contexte prolongé. PACT se distingue en traitant l'incertitude épistémique par le dialogue explicite plutôt que par des mécanismes d'inférence silencieux, une approche complémentaire aux méthodes VLA (Vision-Language-Action) actuellement dominantes. La publication reste un preprint sans validation industrielle annoncée ; l'étape critique sera de quantifier le coût cognitif réel des clarifications répétées pour l'utilisateur dans des contextes de travail prolongés.

UEDes équipes européennes dont l'INRIA (France) et TU Delft (Pays-Bas) travaillent sur des mécanismes similaires d'apprentissage contextuel prolongé, ce qui positionne PACT comme référence pertinente pour la communauté HRI européenne, sans impact industriel direct à ce stade.

RecherchePaper
1 source
Repenser les implications du retour humain pour l'apprentissage des préférences dans la collaboration homme-robot
2arXiv cs.RO 

Repenser les implications du retour humain pour l'apprentissage des préférences dans la collaboration homme-robot

Une équipe de recherche en interaction homme-robot publie sur arXiv (2609.13982) une remise en cause de la méthode standard d'apprentissage des préférences pour le comportement des robots collaboratifs. Cette méthode standard fonctionne en trois étapes : le robot collecte un feedback humain direct limité, généralement binaire (positif ou négatif) ; il en déduit ensuite des étiquettes "acceptée" ou "rejetée" pour des actions faisables mais non choisies, via des règles d'implication fixes préétablies ; puis il met à jour son modèle de récompense avec l'ensemble de ces données. Une étude utilisateur menée sur deux environnements de simulation collaboratifs montre que les étiquettes d'implication réellement données par les humains divergent souvent de ce que prédit la règle fixe, et que l'usage des étiquettes humaines réelles améliore nettement l'apprentissage de récompense avec l'algorithme PIE (Preference Learning from Implicit and Explicit Feedback). Les chercheurs proposent en réponse IMPLIED, une méthode qui utilise la règle fixe comme simple point de départ tout en apprenant à inférer et corriger les étiquettes au fil des interactions. Testée sur des trajectoires d'interaction homme-robot enregistrées ainsi que sur une étude avec un robot physique préparant des pizzas, IMPLIED prédit les implications humaines plus fidèlement que la règle fixe et que des références basées sur des LLM, en se rapprochant des performances d'un oracle utilisant directement des étiquettes humaines. Ce résultat questionne une hypothèse implicite largement répandue dans la conception des systèmes de robots collaboratifs : que des règles logiques figées suffisent à extrapoler les préférences humaines au-delà du feedback explicite donné. Pour les concepteurs de robots d'assistance ou de cobots industriels, cela signifie que les modèles de récompense actuels risquent de mal interpréter systématiquement l'intention des opérateurs sur les actions non directement évaluées, ce qui peut se traduire par un comportement robotique perçu comme irrationnel ou mal aligné en situation réelle de collaboration. En réduisant l'erreur d'estimation des préférences, IMPLIED promet des robots capables de s'adapter plus vite et plus fidèlement à un opérateur humain sans multiplier les sollicitations de feedback, un enjeu direct pour l'efficacité des déploiements en environnement partagé homme-robot. Le travail s'inscrit dans la lignée des approches d'apprentissage de préférences par renforcement inverse appliquées à la robotique collaborative, où l'algorithme PIE sert de référence pour combiner feedback explicite et implicite. En comparant IMPLIED à la fois à la règle fixe classique et à des références utilisant des grands modèles de langage, les auteurs positionnent leur méthode comme une alternative apprise et adaptative aux heuristiques statiques du domaine. La validation combine environnements simulés et un cas d'usage physique concret de fabrication culinaire, suggérant une voie vers une intégration future dans des architectures de robots collaboratifs déployés en usine ou en environnement de service.

RecherchePaper
1 source
Apprendre à assister : des modèles VLA collaboratifs pour la coopération implicite humain-robot
3arXiv cs.RO 

Apprendre à assister : des modèles VLA collaboratifs pour la coopération implicite humain-robot

Des chercheurs ont publié le 12 juin 2026 (arXiv:2606.12475) une étude sur l'usage de modèles vision-langage-action (VLA) entraînés par imitation learning pour la collaboration humain-robot (HRC) implicite, sans signal explicite déclenchant l'assistance robotique. Évaluant deux VLA de référence sur des tâches d'assemblage collaboratif, l'équipe identifie un défaut propre aux politiques d'action-chunking : la "fuite d'actions de démonstration" (demonstration action leakage). Ce phénomène survient lorsque des chunks d'actions enjambent des transitions latentes de sous-tâches, poussant le robot à assister l'humain trop tôt, comme tendre un outil avant que l'opérateur soit prêt à le saisir. Pour corriger ce comportement sans réentraîner le modèle, les auteurs proposent un pilotage à l'inférence (inference-time steering). Une étude à 16 participants sur une tâche d'assemblage longue horizon confirme que le steering réduit les interventions prématurées, accélère la collaboration et diminue les échecs par rapport à une politique à horizon court. Ce résultat ouvre une voie concrète pour l'intégration des VLA dans des workflows industriels collaboratifs, jusqu'ici dépendants de pipelines codés à la main, peu scalables vers de nouvelles tâches. La fuite d'actions constitue un avertissement direct pour les équipes déployant des politiques ACT ou diffusion en mode HRC : allonger l'horizon d'exécution, souvent souhaitable pour la fluidité du mouvement, aggrave le problème. Le steering à l'inférence fournit un correctif opérationnel sans modification du modèle entraîné, ce qui le rend attractif pour un déploiement rapide. Les VLA généralistes comme Pi-0 (Physical Intelligence), OpenVLA ou GR00T N2 (NVIDIA) ont prouvé leur efficacité en manipulation autonome, mais leur usage en HRC implicite restait peu documenté. Cette publication comble ce manque méthodologique. En Europe, des acteurs comme Enchanted Tools et Wandercraft, dont les robots sont conçus pour opérer aux côtés d'humains, pourraient réduire leur charge d'ingénierie manuelle en s'appuyant sur ces résultats. La prochaine étape sera d'étendre la méthode à des environnements industriels non contrôlés et à des tâches encore plus longues, afin d'évaluer la robustesse du steering face à la variabilité réelle des comportements humains.

UEEnchanted Tools et Wandercraft, acteurs européens de la robotique collaborative, pourraient réduire leur charge d'ingénierie manuelle en adoptant le steering à l'inférence pour corriger la fuite d'actions dans leurs déploiements VLA, sans réentraîner leurs modèles.

RechercheOpinion
1 source
De la cognition au contrôle : apprentissage multi-agents pour le transport collaboratif humain-humanoïde
4arXiv cs.RO 

De la cognition au contrôle : apprentissage multi-agents pour le transport collaboratif humain-humanoïde

Des chercheurs ont présenté C2C (Cognition-to-Control), une architecture de collaboration homme-robot pour le transport d'objets, dans une version mise à jour d'un article publié sur arXiv (2603.03768v2, catégorie "replace"). Plutôt que de standardiser les modules logiciels eux-mêmes (planificateur, modèle du partenaire, politique de coordination, contrôleur), C2C standardise les signaux physiques échangés entre eux : un chemin de charge vérifié géométriquement pour représenter l'intention de tâche, un état physique indépendant de sa source pour décrire le partenaire, des commandes bornées en espace de tâche à 11 dimensions pour la coordination apprise, la faisabilité propre au robot restant du ressort du contrôle corps entier (whole-body control). Le système de référence associe un modèle vision-langage, une vérification géométrique déterministe et de l'apprentissage par renforcement multi-agent (MARL) sensible au partenaire ; sur neuf scénarios de transport, les variantes MARL adaptatives atteignent 77,1 à 82,1 % de succès moyen, contre 56,5 % pour une référence à partenaire scripté. Sur robot physique, un Unitree G1 associé à un humain obtient 100 % de succès en transport dans un espace confiné et 80 % pour la manipulation d'objets très longs, et un système à trois porteurs (deux humanoïdes G1 et un humain) valide la même structure d'interface sur matériel réel. Le problème visé est concret pour les intégrateurs : les piles de collaboration homme-robot pleinement intégrées deviennent fragiles dès qu'on change un seul composant, par exemple en remplaçant un partenaire simulé par un humain, ou une équipe à deux porteurs par une équipe à trois. En montrant que la même interface reste fonctionnelle avec des acteurs neuronaux ou des arbres de décision interprétables, avec deux ou trois porteurs, et avec une substitution simulation-vers-réel, les auteurs suggèrent qu'un système de transport collaboratif homme-humanoïde peut être construit de façon modulaire plutôt que reconstruit à chaque itération. C'est un signal pertinent pour les déploiements d'humanoïdes en logistique et en usine, où la coordination physique fiable avec des opérateurs humains reste un frein avant la montée en échelle commerciale. Ce travail s'inscrit dans la vague de recherche combinant modèles vision-langage-action et apprentissage multi-agent pour la robotique humanoïde, où l'écart entre démonstrations simulées et performance réelle reste un point de friction classique du secteur. Le choix du Unitree G1, robot bipède largement utilisé par les laboratoires académiques pour ce type d'expérimentation en raison de sa disponibilité commerciale, situe l'étude comme une validation de laboratoire plutôt qu'un déploiement industriel : l'article ne mentionne ni institution ni entreprise partenaire, ni calendrier de mise en production, et les scénarios à deux et trois porteurs testés ouvrent la voie à une généralisation vers des équipes homme-robot plus larges comme prochaine étape.

RecherchePaper
1 source