
Aller au contenu principal
GraspTune : affinement de l'exécution de la préhension guidé par le toucher
RecherchearXiv cs.RO 

GraspTune : affinement de l'exécution de la préhension guidé par le toucher
1 source couvre ce sujet·Source originale ↗·
Résumé IASource uniqueImpact UE
GraspTune : affinement de l'exécution de la préhension guidé par le toucher
▶ Voir sur YouTube

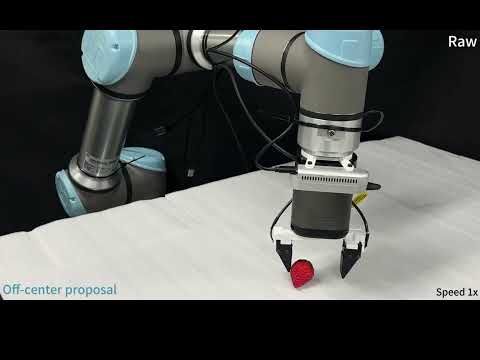
Une équipe de recherche publie sur arXiv (identifiant 2609.24180, prétirage soumis le 22 septembre 2026) GraspTune, un système qui corrige en temps réel l'exécution d'une prise robotique après qu'un algorithme de vision a proposé où saisir un objet. Concrètement, GraspTune applique de petits mouvements résiduels bornés au point de contrôle de l'outil (TCP) pendant l'approche, la formation du contact et la fermeture finale de la pince, en s'appuyant sur la profondeur locale, des signaux tactiles, l'état du bras et l'historique des mouvements. Le système combine des requêtes de contact conditionnées par l'état, une supervision multi-tâche sur le changement de contact, le risque de contact et la préparation post-fermeture, une politique résiduelle pré-entraînée par diffusion et un ajustement par PPO pour un contrôle en boucle fermée. Testé sur plus de 60 000 exécutions simulées couvrant 20 catégories d'objets, GraspTune améliore le taux de prises stables de +19,22 points pour GraspNet, +9,55 pour Contact-GraspNet, +12,45 pour AnyGrasp et +20,70 pour VGN. Sur des objets jamais vus, le taux de réussite passe de 54,58% à 70,33%. En conditions réelles, sur un bras UR5e équipé de capteurs tactiles Xense et plus de 1 000 essais, le taux avec GraspNet grimpe de 71,0% à 84,3%, sans aucun réentraînement de la politique sur données réelles.

L'intérêt principal tient à ce que GraspTune ne remplace pas les générateurs de propositions de prise mais se greffe dessus comme une couche d'exécution générique, améliorant simultanément quatre algorithmes différents sans les modifier. Cela répond directement à un problème connu du secteur: la génération visuelle de propositions de prise a beaucoup progressé, mais transformer une proposition visuellement plausible en prise physiquement stable reste le point de rupture entre démonstration et déploiement réel. Le transfert direct simulation vers robot réel, sans calibration ni réentraînement, est le résultat le plus significatif pour les intégrateurs qui cherchent à réduire le coût de collecte de données terrain pour la manipulation en environnement encombré ou pour des objets à géométrie variable.

Le travail s'inscrit dans une tendance de recherche qui sépare la décision de "où saisir" (perception) du "comment exécuter" (contrôle tactile en boucle fermée), en s'appuyant sur des générateurs de référence déjà largement utilisés dans la littérature sur la préhension robotique. Aucun acteur industriel ni déploiement commercial n'est mentionné: il s'agit d'un travail académique accompagné d'une vidéo supplémentaire de démonstration, dont les prochaines étapes annoncées concernent la validation sur d'autres configurations de pince et de capteurs tactiles.

Dans nos dossiers

À lire aussi

Classement pré-exécution conscient de l'exécution pour le placement robotique conditionné par la préhension
1arXiv cs.RO 

Classement pré-exécution conscient de l'exécution pour le placement robotique conditionné par la préhension

Un article publié en septembre 2026 sur arXiv (2609.19946) présente une méthode qui classe les couples prise-pose avant de lancer la planification de trajectoire, car une prise géométriquement valide peut rester inexécutable une fois prise en compte la pose finale de l'effecteur et le risque de collision pendant le transport. Le modèle associe un nuage de points conditionné par la cible à trois descripteurs de pose, avec des têtes hiérarchiques qui évaluent séparément la réussite de la planification puis celle de l'exécution. Sur un jeu de 30 objets et 1 235 scènes, avec des groupes de test disjoints de l'entraînement, le taux de réussite du candidat classé en tête (top-1) atteint 85,63% en sélection conjointe de la prise et de la pose, et 79,84% à cible fixée, contre 72,84% et 59,65% pour une planification exhaustive de référence via le moteur cuMotion. Transféré sans réentraînement spécifique sur un bras xArm7 piloté par MoveIt, le système réussit 13 des 27 cas testés de bout en bout (48,15%), et 13 des 16 cas ayant franchi le contrôle préalable top-5 (81,25%). Pour les intégrateurs de cellules de manipulation, ce travail cible un angle mort courant des pipelines de prise-dépose: la prise est souvent choisie pour sa seule stabilité, sans vérifier si la pose de dépôt qui en résulte reste exécutable par le bras. Classer les couples prise-pose avant de solliciter un planificateur coûteux comme cuMotion promet de réduire le temps de calcul et les échecs tardifs, un enjeu concret pour le bin-picking industriel et la logistique automatisée. L'écart entre le score académique, supérieur à 85% en top-1, et le taux de réussite réel de bout en bout, inférieur à 50% sur les cas verrouillés, rappelle que la fiabilité en conditions d'exécution reste un problème largement ouvert. Cette approche s'inscrit dans une tendance de la recherche en manipulation qui associe des modules de scoring appris à des planificateurs classiques comme cuMotion (NVIDIA) et MoveIt (ROS), plutôt que de confier la tâche à une politique de bout en bout. Publié en préprint sans affiliation industrielle ni partenariat annoncés, l'article reste un résultat de laboratoire, validé sur un jeu de données fermé et un bras de test, non un produit commercialisé.

RecherchePaper
1 source
TacRefineNet : affinage de la préhension tactile guidé par objectif pour objets à arêtes saillantes
2arXiv cs.RO 

TacRefineNet : affinage de la préhension tactile guidé par objectif pour objets à arêtes saillantes

Une équipe de recherche présente TacRefineNet, un système d'affinage tactile de prise pour objets à géométrie fine comme les plaques, disques et tiges, dont les contacts épars sont difficiles à capter par la vision en profondeur. Le framework utilise un réseau siamois entraîné à comparer les images tactiles multi-doigts actuelles et cibles, ainsi que les configurations articulaires de la main, pour prédire directement des corrections incrémentales de la pose du poignet. La main ouvre, déplace et resaisit l'objet de façon itérative, formant une boucle de servocontrôle tactile à dextérité externe. Les chercheurs ont collecté 156 007 échantillons simulés à partir de 15 objets (plaques, disques, tiges) et entraîné la politique entièrement dans MuJoCo avant un déploiement zero-shot sur une main à cinq doigts et 11 degrés de liberté équipée de capteurs piézorésistifs. Sur des objets déjà vus, le système réel atteint un taux de réussite de 80,7% pour les cibles fixes et 59,3% pour les cibles aléatoires selon le critère de 10 degrés et 10 mm, avec des erreurs moyennes d'environ 5,2 mm et 3,5 degrés après cinq étapes de correction. Ce résultat s'attaque à un angle mort précis de la manipulation robotique: les objets fins et symétriques restent un point faible pour les capteurs de profondeur classiques, car leurs surfaces de contact sont trop réduites ou occultées pour une estimation de pose fiable par vision seule. En démontrant qu'un asservissement purement tactile peut corriger l'alignement final avec une précision millimétrique, l'étude conforte l'idée que la fusion vision-tactile, plutôt que la vision seule, sera nécessaire pour les tâches d'assemblage fin en usine ou en logistique. Le transfert zero-shot simulation-vers-réel, sans réentraînement sur le système physique, est aussi un signal encourageant pour réduire le coût de déploiement de ce type de politique sur du nouveau matériel. Le travail s'inscrit dans la lignée des approches de manipulation dextre pilotées par retour tactile, un domaine où la rareté des données réelles pousse les équipes à s'appuyer sur la simulation pour l'entraînement. Les auteurs reconnaissent des limites: le transfert reste restreint à des objets non vus mais proches en catégorie, et la performance chute nettement pour les objets symétriques ou aux contacts peu discriminants, un écueil classique pour toute méthode fondée sur la comparaison d'images de contact. Le système montre en revanche une capacité de correction continue face à des perturbations prolongées, ce qui ouvre la voie à des essais sur des tâches d'assemblage réel où la précision fine de prise est critique, sans qu'aucun calendrier de déploiement industriel ne soit pour l'instant annoncé.

RecherchePaper
1 source
Évolution antérieure et alignement de tâche pour la préhension aérienne
3arXiv cs.RO 

Évolution antérieure et alignement de tâche pour la préhension aérienne

Un article publié le 17 septembre 2026 sur arXiv (référence 2609.18153) détaille une nouvelle méthode pour la préhension aérienne, cette capacité qu'ont les rapaces à capturer une proie en vol grâce à des manœuvres hautement coordonnées. Les chercheurs partent d'un constat sur les approches existantes fondées sur l'optimisation de trajectoire: le problème mathématique posé est fortement non convexe et très sensible aux conditions initiales, ce qui rend difficile l'obtention de solutions de bonne qualité avec un budget de calcul limité, et les objectifs numériques utilisés jusqu'ici sont des abstractions conçues par des humains qui ne capturent pas forcément tout ce qui détermine la réussite réelle de la saisie. Leur réponse combine trois briques: un "prior" de trajectoire appris à partir de mouvements déjà optimisés, un processus d'évolution basé sur la méthode CEM (cross-entropy method) qui teste des points de départ échantillonnés avec l'optimiseur réellement utilisé et ne conserve que les meilleurs comme nouvelles données d'entraînement, et un "Execution-Aware Critic" qui apprend à partir des résultats de contact, de soulèvement de l'objet et de complétion de la tâche pour prédire si une trajectoire optimisée réussira une fois exécutée physiquement. Une fois entraîné et figé, ce critique fait aussi office de coût de préhension différentiable qui influence directement la génération de trajectoire. Les auteurs rapportent des essais en simulation et sur système réel montrant une meilleure fiabilité d'optimisation, plus de cohérence entre trajectoires et de meilleures performances de saisie. Pour l'industrie robotique, ce travail s'attaque à un verrou classique de la planification par optimisation: la dépendance à l'initialisation, qui oblige souvent à relancer le solveur de nombreuses fois ou à accepter des trajectoires sous-optimales sous contrainte de temps de calcul. En faisant apprendre au système ce qui distingue une trajectoire viable d'une trajectoire qui échouera à l'exécution, plutôt que de se fier uniquement à des critères mathématiques fixés a priori, l'approche illustre une tendance plus large du secteur: hybrider planification analytique classique et apprentissage à partir de données d'exécution réelle, au lieu d'opposer les deux paradigmes. Il faut toutefois noter que l'abstract ne fournit aucun chiffre de taux de réussite, de temps de cycle ni d'échelle de déploiement: il s'agit d'un travail de recherche en amont, validé en simulation et par des essais réels limités, pas d'un système prêt pour un déploiement industriel. Ce papier s'inscrit dans la lignée des travaux sur la manœuvrabilité agile des drones et la manipulation aérienne, un champ de recherche actif depuis plusieurs années autour de la génération de trajectoires pour capturer des objets en mouvement ou en position complexe. Aucune entreprise ni laboratoire n'est nommé dans le résumé, et aucun acteur français ou européen du secteur n'est mentionné dans cette publication. Les suites logiques d'un tel travail seraient une extension à des scénarios de préhension plus variés, des tests sur davantage de plateformes matérielles, et une comparaison directe avec d'autres méthodes d'optimisation de trajectoire pour la préhension aérienne, mais aucune de ces étapes n'est annoncée à ce stade.

RecherchePaper
1 source
Accélérer l'inférence des VLA grâce à une exécution guidée par les perturbations
4arXiv cs.RO 

Accélérer l'inférence des VLA grâce à une exécution guidée par les perturbations

Des chercheurs proposent PICES (Perturbation-Informed Chunk and Execution Horizon Selection), une méthode sans entraînement qui accélère l'inférence des modèles vision-langage-action (VLA) à découpage d'actions. Ces modèles prédisent des séquences d'actions futures, appelées chunks. Avec l'exécution à horizon fixe, le robot n'exécute qu'un préfixe de longueur constante avant de rappeler la politique, et le reste du chunk est jeté. PICES choisit, au sein d'un même appel, le chunk à exécuter et le nombre d'actions à jouer avant le prochain appel. L'expert d'actions génère un lot de chunks à partir de plusieurs bruits initiaux et de leurs versions localement perturbées, avec les mêmes caractéristiques de conditionnement. L'écart entre chaque action nominale et son homologue perturbée sert à fixer un horizon d'exécution propre à chaque candidat, puis à retenir un chunk nominal. Les tests couvrent des benchmarks en simulation et des tâches de manipulation réelles. Ils annoncent jusqu'à 2,3 fois moins de temps d'inférence (mesuré en temps réel) sur Jetson Orin et Jetson Thor, par rapport aux références à horizon fixe, avec un taux de réussite amélioré. Le résumé ne donne ni les modèles de base, ni les tâches, ni les gains de réussite chiffrés. L'inférence d'un VLA est coûteuse sur le matériel embarqué, et c'est un frein concret au déploiement. Un horizon court permet des corrections précises mais multiplie les appels, tandis qu'un horizon long amortit le coût au prix de la réactivité. PICES vise à adapter cet arbitrage à chaque situation. L'intérêt pour les intégrateurs tient à trois points. La méthode ne demande aucun réentraînement, donc elle peut s'appliquer à des politiques déjà en place. Elle cible les plateformes Jetson Orin et Thor, très répandues dans la robotique embarquée. Et elle utilise un seul passage batché, ce qui limite le surcoût. Il faut tout de même nuancer. Le « jusqu'à 2,3x » est un maximum, probablement obtenu dans le cas le plus favorable. Le gain moyen, la variance entre tâches et la robustesse hors benchmark restent à vérifier dans l'article complet. Il s'agit d'une preuve de concept académique, pas d'un produit livré ni d'un déploiement industriel. Ce travail s'inscrit dans la course à l'efficacité des VLA à flow matching ou diffusion, comme Pi-0 ou GR00T, dont la fréquence de décision reste limitée sur des puces embarquées. Les approches rivales passent par la distillation, la quantification, la mise en cache ou l'exécution asynchrone, avec ou sans « temporal ensembling ». PICES a l'avantage de s'y combiner sans modifier les poids. La suite logique serait une validation sur plus de modèles, sur des tâches à contacts riches et sur des cycles de production réels, avec des mesures de latence de bout en bout et pas seulement du temps d'inférence de la politique.

RecherchePaper
1 source