
Aller au contenu principal
Robot humanoïde à patins en ligne piloté par apprentissage par renforcement
RecherchearXiv cs.RO 

Robot humanoïde à patins en ligne piloté par apprentissage par renforcement
1 source couvre ce sujet·Source originale ↗·
Résumé IASource uniqueImpact UE
Robot humanoïde à patins en ligne piloté par apprentissage par renforcement
▶ Voir sur YouTube

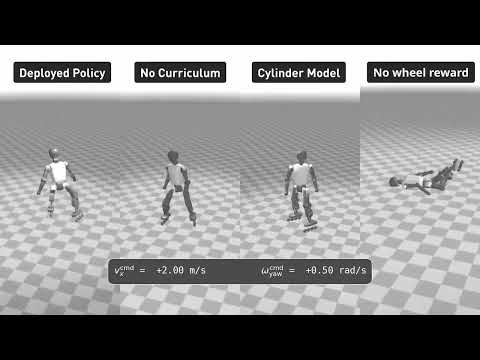
Des chercheurs ont entraîné un policy de contrôle par apprentissage par renforcement (RL) pour piloter un robot humanoïde équipé de patins à roues alignées (rollers) grand public à la place des pieds classiques. Le système commande les patins avec 6 degrés de liberté (DoF) et exécute des stratégies de propulsion dynamiques basées sur les carres, comme le font les patineurs humains. Contrairement aux travaux antérieurs limités aux robots quadrupèdes ou aux roues motorisées activement, cette approche fonctionne avec des roues passives, sans moteur dans les roues elles-mêmes. Les comportements de patinage émergent uniquement de la structure de récompense, sans données de mouvement humain, sans apprentissage par imitation ni a priori cinématiques. Pour gérer l'instabilité des roues passives et les artefacts de contact en simulation, les auteurs ont utilisé des modèles géométriques de roues différents à l'entraînement et à la validation (sphériques et ellipsoïdaux), un curriculum de commandes basé sur le taux de succès, et une récompense spécifique au roulement. Résultat: une réduction allant jusqu'à 50% du coût de transport (Cost of Transport) par rapport à une démarche marchée classique. Le policy a été transféré zéro-shot sur le robot Booster T1 réel, avec équilibre dynamique démontré, capacité à encaisser des perturbations physiques actives, et virages agiles à vitesse.

L'intérêt dépasse l'anecdote technique: c'est une nouvelle preuve que le RL pur, sans données de démonstration humaine, peut produire des comportements locomoteurs complexes et efficaces énergétiquement, transférables directement du simulateur au réel sans réentraînement. Pour les équipes qui travaillent sur la locomotion humanoïde, cela ouvre une piste alternative aux pieds ou aux roues motorisées: des accessoires passifs à faible coût combinés à un contrôleur suffisamment sophistiqué pour compenser la sous-actionnement mécanique.

Le travail s'inscrit dans la lignée des recherches sur la locomotion RL pour robots à pattes, qui a déjà permis des transferts sim-to-real robustes pour la marche et la course. Ici l'équipe étend le paradigme à un mode de locomotion inhabituel et instable par nature. Le choix du Booster T1, plateforme humanoïde chinoise à bas coût plus accessible que les Unitree G1 ou Figure 03, suggère aussi une recherche pensée pour la reproductibilité académique plutôt que pour la démonstration commerciale.

Dans nos dossiers

À lire aussi

RGB : MPPI corps entier pour humanoïdes guidé par apprentissage par renforcement
1arXiv cs.RO 

RGB : MPPI corps entier pour humanoïdes guidé par apprentissage par renforcement

Une équipe de recherche a publié sur arXiv (référence 2606.25123) une architecture de contrôle hybride baptisée RGB, pour "RL Guided whole-body MPPI", destinée aux robots humanoïdes évoluant dans des environnements à contacts complexes. Le framework a été évalué en simulation MuJoCo sur un Unitree G1 à 29 degrés de liberté, avec une fréquence de contrôle moyenne de 280 Hz. Le principe : au lieu d'utiliser une politique d'apprentissage par renforcement (RL) comme contrôleur final, RGB l'emploie comme prior d'échantillonnage pour guider les rollouts d'un algorithme MPPI (Model Predictive Path Integral). Les objectifs de tâche sont définis via des termes de coût modulaires MPPI, qui corrigent en ligne la politique RL pour satisfaire ces objectifs sans nécessiter de réentraînement. Les tests montrent une réduction de la dérive systématique en marche rectiligne et une meilleure capacité à suivre des signaux de référence corps entier supplémentaires, comparé à une politique RL pure sous la même interface de commande. L'intérêt industriel de cette approche réside dans la rigidité structurelle des politiques RL actuelles : une fois entraînée, une politique couple fortement son comportement à l'objectif d'entraînement et à l'interface de commande. Ajouter un nouvel objectif de feedback (correction de trajectoire, contrainte de contact, suivi d'un membre spécifique) exige généralement un réentraînement complet, coûteux et long. RGB court-circuite cette contrainte en déléguant la précision et la modularité au MPPI, qui opère en boucle fermée à haute fréquence. Pour un intégrateur industriel ou un COO qui doit adapter un humanoïde à plusieurs lignes de production, la possibilité de spécifier de nouveaux comportements via des termes de coût, sans retouch au modèle RL sous-jacent, représente un gain de flexibilité concret. La fréquence de 280 Hz en simulation est encourageante, mais les auteurs ne démontrent pas encore le transfert sim-to-real, ce qui reste le saut critique pour toute validation industrielle. Le cadre MPPI est une technique de contrôle prédictif par échantillonnage bien établie en robotique mobile et manipulation, mais son couplage avec une politique RL comme prior pour les humanoïdes corps entier est une direction récente. Unitree, dont le G1 est devenu une plateforme de recherche courante grâce à son accessibilité commerciale (autour de 16 000 dollars), est au coeur de nombreux travaux académiques concurrents, notamment autour des architectures VLA (Vision-Language-Action) de type GR00T N2 de NVIDIA ou Pi-0 de Physical Intelligence. RGB se positionne dans un créneau distinct : il ne vise pas la généralisation via des données de démonstration, mais l'optimisation en ligne de politiques existantes. La prochaine étape logique sera une validation sur hardware réel, déterminante pour établir si les 280 Hz de simulation se maintiennent face aux incertitudes mécaniques et aux latences capteurs d'un vrai G1.

RecherchePaper
1 source
R³ : entraîner des robots à raisonner en langage naturel par apprentissage par renforcement
2arXiv cs.RO 

R³ : entraîner des robots à raisonner en langage naturel par apprentissage par renforcement

Des chercheurs présentent R³ (R-cubed), une méthode de post-entraînement qui transforme des modèles vision-langage (VLM) génériques en « raisonneurs robotiques » capables de guider des politiques de manipulation bas niveau. La recette se déroule en deux temps : un VLM est d'abord entraîné (mid-training) sur des traces de raisonnement générées par des experts pour installer un style de raisonnement adapté, puis affiné par apprentissage par renforcement à un pas, fondé sur des grilles d'évaluation (rubric-based RL), à partir de données d'action hors ligne. L'équipe a testé R³ sur deux bancs d'essai contrôlés : Language Table et une tâche simulée d'emballage de courses à deux bras (bimanual grocery packing). Sur ces deux benchmarks, R³ améliore l'exploration et la généralisation vers des tâches non vues à l'entraînement, et surpasse nettement des références d'apprentissage par imitation guidées uniquement par instruction. Le travail est publié en préprint sur arXiv (2608.26053, août 2026) et une page de projet est disponible à robotic-reasoner.github.io. La particularité de R³ tient à la nature du raisonnement produit : contrairement aux méthodes robotiques antérieures, qui utilisent des traces structurées comme simple supervision auxiliaire à l'entraînement, R³ entraîne le modèle à produire un raisonnement en langage libre qui sert directement de guidage au moment de l'exécution, pour piloter des politiques bas niveau souvent bruyantes. L'enjeu dépasse l'exercice académique : les tâches robotiques à long horizon exigent de suivre une progression partielle, de raisonner sur les relations entre objets et de détecter puis corriger des erreurs, des compétences que l'apprentissage par imitation pure peine à capturer. Ces résultats apportent un signal utile au débat en cours dans le secteur des modèles vision-langage-action (VLA), où des acteurs comme Physical Intelligence (Pi-0), NVIDIA (GR00T N2) ou Figure (Helix) cherchent à doter bras manipulateurs et robots humanoïdes d'un raisonnement transférable de la simulation au monde réel. R³ suggère que le raisonnement en langage libre, popularisé par les modèles de type o1 sur des problèmes textuels complexes, peut aussi fonctionner comme mécanisme de calcul au moment du test pour la manipulation robotique. Ce travail s'inscrit dans une tendance plus large visant à transférer aux robots les gains obtenus par les modèles de fondation lorsqu'ils « réfléchissent » avant d'agir, capacité qui a déjà transformé les performances des grands modèles de langage sur les problèmes nécessitant décomposition et anticipation des conséquences. Jusqu'ici, les approches de raisonnement robotique se contentaient le plus souvent d'un signal auxiliaire sans que ce raisonnement pilote réellement l'action finale, ce que R³ cherche précisément à corriger. Les résultats publiés restent toutefois circonscrits à des environnements contrôlés et largement simulés, sans démonstration sur un déploiement réel à grande échelle ni comparaison directe avec des systèmes commerciaux déjà en service. Les auteurs ne précisent pas de calendrier de portage vers des robots physiques ou de tests sur des tâches industrielles plus complexes, ce qui situe R³ comme une contribution de recherche amont plutôt qu'un produit prêt à l'intégration.

RecherchePaper
1 source
ResSafe : filtrage de sécurité par apprentissage par renforcement résiduel pour humanoïdes
3arXiv cs.RO 

ResSafe : filtrage de sécurité par apprentissage par renforcement résiduel pour humanoïdes

ResSafe, une architecture de contrôle en deux politiques pour les robots humanoïdes, a été publiée le 15 septembre 2026 sur arXiv sous la référence 2609.15988. La méthode sépare performance et sécurité : une politique nominale est entraînée uniquement pour accomplir la tâche, tandis qu'une politique résiduelle apprend en parallèle des corrections de sécurité qui ajustent ses actions. Cette seconde politique agit comme un filtre de sécurité implicite, censé limiter chutes et instabilités liées à la dynamique à haute dimensionnalité et aux interactions riches en contacts propres aux humanoïdes. L'abstract ne cite aucune plateforme robotique ni aucun chiffre de performance (taux de chute, distance parcourue, degrés de liberté), signe d'une recherche encore amont, sans validation matérielle détaillée. Pour l'industrie, ce découplage répond à un problème connu : faire arbitrer par une seule politique performance, robustesse et sécurité oblige à régler manuellement plusieurs termes de récompense concurrents, un exercice fragile qui complique le passage du simulateur au robot réel. En sortant la sécurité de cette équation unique, ResSafe propose une approche modulaire qui, si elle se confirme sur du matériel, pourrait faciliter l'ajout de correctifs de sécurité sans réentraîner toute la politique de locomotion. L'enjeu parle directement aux intégrateurs et décideurs du secteur, confrontés à un écart persistant entre démonstrations en simulation et fiabilité en conditions réelles. Le travail s'inscrit dans une recherche académique plus large sur le contrôle par apprentissage des humanoïdes, où le RL pour la locomotion et le suivi de mouvement s'est largement généralisé ces dernières années. Il se distingue des méthodes de filtrage de sécurité explicite, fondées sur des barrières de contrôle ou des modèles analytiques de la dynamique, souvent coûteuses ou difficiles à généraliser à un système aussi complexe. L'article ne mentionne ni code source, ni partenaire industriel, ni calendrier d'essais sur robot physique : ResSafe reste, à ce stade, une contribution de recherche dont l'apport devra être confirmé au-delà de la simulation.

RecherchePaper
1 source
Bicyclette Acrobatique : l'Apprentissage par Renforcement en Action
4arXiv cs.RO 

Bicyclette Acrobatique : l'Apprentissage par Renforcement en Action

Des chercheurs ont entraîné par apprentissage par renforcement (RL) un robot en forme de vélo, l'Ultra Mobility Vehicle (UMV), une plateforme bicyclette construite sur mesure, à exécuter tout un répertoire de figures acrobatiques dynamiques. Décrite dans la prépublication arXiv:2608.00880v1, l'équipe combine plusieurs formulations de RL (suivi de points de passage, atteinte de pose, suivi de vitesse angulaire, suivi guidé et imitation de mouvement) pour apprendre au robot à sauter en avant et sur le côté, en solo ou par-dessus plusieurs tables, à orienter ses sauts, à enchaîner front flips, kip-ups et kip-downs, ainsi qu'à rouler, faire des wheelies, des bunny hops et des demi-tours en trois points. Un orchestrateur gère les transitions entre ces politiques grâce à des déclencheurs conditionnés à l'état du robot, ce qui permet d'enchaîner des séquences longues sans intervention humaine. En simulation comme sur le matériel réel, l'UMV franchit répétitivement des tables allant jusqu'à 1 mètre de haut, réalise plus de 15 sauts autonomes consécutifs en suivant des points de passage, s'adapte à des configurations de tables inédites, enchaîne kip-ups, sauts, flips et kip-downs sur plus de 20 essais consécutifs, et exécute plus de 10 répertoires consécutifs de wheelies, sauts latéraux et descentes sur une roue en configuration orientable. Ce résultat déplace une frontière jusqu'ici associée presque exclusivement aux robots à pattes : la capacité à composer des figures acrobatiques complexes et robustes dans la durée. Un robot à roues, sous-actionné et soumis à des contraintes non-holonomes réputées difficiles à contrôler, atteint ici un niveau d'agilité comparable tout en conservant la vitesse et l'efficacité énergétique propres à la locomotion à roues. Pour les équipes de recherche en robotique mobile, cela confirme que le RL peut s'étendre à des morphologies non conventionnelles au-delà des humanoïdes et quadrupèdes, avec un intérêt potentiel pour la logistique ou les usages tout-terrain rapides. Le travail s'inscrit dans la lignée des démonstrations d'agilité par RL popularisées par les robots à pattes (Boston Dynamics, Unitree), mais l'applique à une plateforme bicyclette peu explorée jusqu'ici en raison de sa dynamique d'équilibre complexe. Il s'agit pour l'instant d'une publication de recherche, pas d'un produit commercialisé : les auteurs présentent ces résultats comme une base pour de futurs travaux sur l'acrobatie à vélo, sans calendrier de déploiement industriel annoncé.

RecherchePaper
1 source