
Aller au contenu principal
Daimon Robotics et Galbot lancent RobOmni pour évaluer la perception tactile et la manipulation dextérique
RechercheRobotics Business Review 

Daimon Robotics et Galbot lancent RobOmni pour évaluer la perception tactile et la manipulation dextérique

1 source couvre ce sujet·Source originale ↗·
Résumé IASource uniqueImpact UE
Daimon Robotics et Galbot lancent RobOmni pour évaluer la perception tactile et la manipulation dextérique
▶ Voir sur YouTube

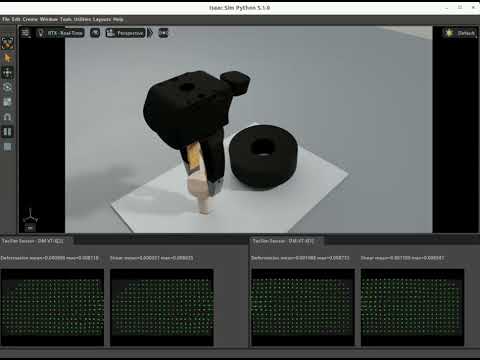
Daimon Robotics, entreprise de Hong Kong spécialisée dans la perception tactile et la manipulation dextre, a présenté RobOmni lors de l'ICRA 2026, en partenariat avec Galbot. Il s'agit du premier benchmark d'évaluation omni-modal intégrant la perception tactile pour les interactions physiques en robotique. La plateforme, construite sur NVIDIA Isaac Sim, standardise l'évaluation de tâches de manipulation au contact : saisie d'objets, insertion de précision, assemblage de composants et placement. RobOmni capture simultanément plusieurs flux de données, capteurs tactiles haute résolution au bout des doigts, vision RGB montée au poignet, état de la pince, trajectoires TCP et observations de caméras externes, pour évaluer les systèmes robotiques selon cinq dimensions : taux de succès, efficacité de manipulation, capacité de manipulation dextre, événements d'échec (glissement, coinçage, collision, nouvelle tentative) et robustesse de généralisation.

Ce lancement répond à un manque structurel dans l'industrie : l'absence de cadre standardisé pour mesurer l'apport réel du sens tactile par rapport à la perception purement visuelle. Sans benchmark unifié, il est impossible de comparer les systèmes, de quantifier les progrès ou d'identifier quelles données tactiles améliorent concrètement les tâches réelles. Pour les intégrateurs industriels et les décideurs B2B qui évaluent des bras manipulateurs pour des lignes d'assemblage ou de service, ce vide est critique : une manipulation fiable dans des environnements non structurés requiert de détecter le glissement, la déformation du contact ou la rigidité d'un matériau lors d'un emboîtement, autant de signaux que la vision seule ne peut pas capturer. RobOmni propose de quantifier systématiquement cet apport, ce qui permettrait notamment de comparer des architectures VLA (Vision-Language-Action) avec et sans retour tactile sur des tâches identiques.

Daimon Robotics a développé ses propres capteurs tactiles basés sur la vision, capables de mesurer non seulement la force de contact mais aussi la déformation, le glissement, les propriétés de matériau, la texture et la dureté, à haute fréquence et haute résolution. Galbot, partenaire du projet, apporte son expertise en robotique mobile et manipulation. Si aucune métrique de performance comparative ni timeline de déploiement commercial ne sont encore publiées, ce lancement reste à ce stade une annonce de framework de recherche, pas un produit expédié, le positionnement à l'ICRA 2026 signale une ambition de standardisation sectorielle. Les concurrents dans l'espace des benchmarks robotiques, notamment Google DeepMind (RoboVerse) et Meta (PARTNR), n'intègrent pas la modalité tactile comme dimension centrale d'évaluation. RobOmni comble potentiellement ce vide, à condition que la communauté adopte le framework comme référence commune.

À lire aussi

Un bout dextérique tactile durable pour la manipulation robotique
1arXiv cs.RO 

Un bout dextérique tactile durable pour la manipulation robotique

Une équipe de chercheurs décrit, dans une prépublication arXiv du 26 août 2026, un embout de doigt tactile robotique à vision conçu pour résister à l'usure, point faible connu des capteurs commerciaux. Il associe un gel de silicone souple, un film protecteur en polyuréthane thermoplastique (TPU) texturé et non pigmenté, et une cartouche de détection remplaçable. Deux tests accélérés ont mesuré sa durabilité : un ponçage sur tambour rotatif, et une sonde répétitive appliquant 39,2 N (4,0 kgf) à 45 cycles par minute. Le film protecteur du nouveau capteur a cédé après 2 à 3 heures de ponçage, tandis que les neuf exemplaires testés sous charge répétitive restaient tous fonctionnels à l'arrêt des essais : sept après 5 jours, un après 6 jours, un après 8 jours. Les capteurs commerciaux GelSight Mini et DIGIT, eux, ont vu leur film se rompre après seulement 24 à 30 secondes de ponçage et 25 à 35 minutes de charge répétitive. La dégradation du nouveau capteur restait progressive, sans gêner l'imagerie tactile. Cette amélioration de plus de deux ordres de grandeur, obtenue dans des conditions de vieillissement accéléré définies par les auteurs eux-mêmes, vise un angle mort de la manipulation robotique : les capteurs tactiles à vision comme GelSight ou DIGIT livrent une image de contact riche mais s'usent vite sous charges concentrées et frottements répétés, ce qui freine leur usage hors laboratoire. Pour les intégrateurs qui veulent faire passer la préhension robotisée de la démonstration au déploiement industriel, une cartouche remplaçable plutôt qu'un capteur à jeter pèse autant sur le coût total de possession que la résolution du signal tactile. Ces chiffres restent toutefois issus de protocoles de laboratoire propres à l'étude, et non d'une validation en usage prolongé sur un bras ou une main robotique en production. GelSight, issu de recherches du MIT, et DIGIT, le capteur tactile ouvert développé par Meta AI, sont devenus des références de facto pour la recherche en préhension et en manipulation fine ; l'usure rapide de leur film de silicone freine depuis longtemps leur adoption au-delà des bancs d'essai académiques, notamment pour des tâches répétitives de tri ou d'assemblage visées par les mains robotiques humanoïdes actuellement en développement. La prépublication ne mentionne aucun partenariat industriel ni calendrier de commercialisation : il s'agit à ce stade d'une validation en laboratoire, dont la suite logique serait un essai en conditions réelles sur un bras ou une main robotique en fonctionnement continu, avant toute intégration dans un produit commercial.

RecherchePaper
1 source
Intelligence tactile par vision pour la robotique : perception, apprentissage et manipulation incarnée
2arXiv cs.RO 

Intelligence tactile par vision pour la robotique : perception, apprentissage et manipulation incarnée

Une équipe de chercheurs publie sur arXiv (arXiv:2608.15490v1, en ligne le 18 août 2026) une revue de synthèse consacrée aux capteurs tactiles à base de vision, ou VBTS (vision-based tactile sensors), pour la robotique. Le papier ne présente ni produit ni robot spécifique, mais dresse un panorama complet de la chaîne technologique : le matériel (design de l'élastomère déformable, taille et forme du capteur, système optique), les méthodes d'apprentissage (du traitement bas niveau du signal jusqu'aux politiques de tâche et aux modèles de fondation), les plateformes de simulation et les jeux de données tactiles, ainsi que les techniques de transfert simulation vers réel et d'adaptation inter-capteurs. Les auteurs proposent une taxonomie matérielle destinée à guider la conception future de capteurs, et une vue hiérarchique de l'intelligence tactile fondée sur l'apprentissage automatique. Le sujet touche un point aveugle connu de la robotique de manipulation : contrairement à la vision, la plupart des capteurs tactiles actuels ne renvoient que des signaux épars et de faible dimension, insuffisants pour des tâches de contact complexes comme la saisie fine, l'insertion ou la manipulation dextre. En convertissant la déformation d'une interface souple en image, les VBTS offrent une observation tactile haute résolution, exploitable par les mêmes architectures que la vision, ce qui ouvre la voie à des politiques de manipulation plus robustes pour bras industriels, mains robotiques et humanoïdes. Pour les intégrateurs et équipes de recherche, l'intérêt du travail tient moins à une avancée ponctuelle qu'à une mise en ordre du champ : en traitant capteur, apprentissage, simulation et données comme un système intégré plutôt que des briques isolées, la revue pointe le manque d'outils de simulation et de jeux de données standardisés qui freine le passage à l'échelle du tactile par rapport à la vision pure. Cette synthèse s'inscrit dans un effort plus large visant à combler le retard du tactile sur la vision et le langage, alors que les modèles vision-langage-action intègrent de plus en plus de modalités sensorielles au-delà de la caméra. Les VBTS, dérivées de capteurs à gel ou membrane filmés par une caméra interne, forment une famille technologique explorée par plusieurs laboratoires depuis plus d'une décennie, mais dont le développement restait fragmenté entre approches matérielles et pipelines logiciels disparates. En cartographiant les défis ouverts (généralisation entre capteurs, réalisme de la simulation, disponibilité des données d'entraînement), les auteurs visent une feuille de route pour la prochaine génération de mains et préhenseurs dotés du sens du toucher. Aucun déploiement industriel ni partenariat commercial n'est mentionné : il s'agit d'un travail académique destiné à orienter la recherche future, pas d'une annonce produit.

RecherchePaper
1 source
Transfert pré-entraînement tactile transférable centré sur l'humain pour la manipulation robotique dextérique
3arXiv cs.RO 

Transfert pré-entraînement tactile transférable centré sur l'humain pour la manipulation robotique dextérique

Les auteurs de cette étude publient H-Tac, un jeu de données tactile-action à grande échelle constitué de 160 heures de vidéos humaines à la première personne, couvrant plus de 300 tâches et totalisant 135 000 épisodes. À partir de cette base, ils proposent Transferable Tactile Pre-Training (TTP), un système de pré-entraînement fondé sur le sens tactile humain, destiné à transférer des compétences de manipulation fine vers des robots. La méthode s'appuie sur des espaces tactiles et d'action unifiés, maintenus identiques pendant les phases de pré-entraînement et de post-entraînement, afin de préserver les connaissances acquises lors du passage de l'humain au robot. Un module expert dédié prédit l'évolution future du signal tactile, ce qui permet de modéliser explicitement la dynamique de contact et les interactions physiques fines. Les auteurs rapportent des performances supérieures aux approches existantes, en simulation comme sur robots réels, avec une bonne capacité de généralisation. Ce travail cible un verrou connu du secteur robotique: le toucher reste la modalité la moins exploitée dans les modèles Vision-Language-Action, alors qu'il est indispensable pour les tâches riches en contact où la vision seule ne suffit pas à estimer une force appliquée. Les jeux de données tactiles existants restent petits et couvrent peu de types de contacts, ce qui limite le plafond de performance des modèles VLA tactiles, dont le post-entraînement reste largement indifférent à la dynamique physique. En s'appuyant sur des vidéos humaines plutôt que sur de la téléopération robotique coûteuse à collecter, H-Tac vise à lever ce goulot d'étranglement de données, une stratégie déjà explorée pour le pré-entraînement d'actions mais rarement appliquée au tactile à cette échelle. Si les résultats se confirment sur d'autres plateformes, cela pourrait rapprocher les robots manipulateurs dextres de tâches fines comme l'insertion de précision ou la manipulation d'objets déformables, au-delà des démonstrations scénarisées. L'article s'inscrit dans la lignée des modèles VLA récents (Pi-0, GR00T N2, Helix) qui combinent perception visuelle et langage mais négligent généralement le retour tactile faute de données adaptées. Publié sur arXiv (2607.01067v1) début juillet 2026, ce travail reste au stade de la recherche académique: aucun partenariat industriel ni déploiement commercial n'est mentionné, et les auteurs présentent TTP comme une preuve de concept ouvrant la voie à un pré-entraînement tactile transférable et passant à l'échelle, plutôt que comme un produit prêt à l'emploi.

RecherchePaper
1 source
Percevoir, prédire et planifier : un modèle d'action du monde unifié pour la manipulation dextérique égocentrique
4arXiv cs.RO 

Percevoir, prédire et planifier : un modèle d'action du monde unifié pour la manipulation dextérique égocentrique

P³-WAM est un modèle d'action fondé sur un modèle du monde (« world action model ») pour la manipulation dextre en vue égocentrique, décrit dans un preprint arXiv (2610.22363). Il réunit trois modes dans un seul réseau. « Perceive » reconstruit en 3D le mouvement d'une main articulée et la trajectoire de la caméra à partir d'une vidéo. « Predict » génère les futurs visuels correspondant à des actions imposées. « Plan » produit conjointement des trajectoires d'actions et leurs conséquences visuelles anticipées, à partir d'une image initiale, d'une instruction en langage naturel et, en option, d'un but visuel. L'architecture greffe une représentation 3D compacte et structurée des actions sur un transformeur de diffusion vidéo préentraîné, via un mélange de transformeurs. Les poids de base sont partagés, chaque modalité a son adaptation propre, et l'attention entre vision et action est bidirectionnelle. Une visibilité aléatoire des modalités permet à la vidéo comme aux actions 3D de servir tantôt de contexte, tantôt de cible. Les auteurs annoncent que l'entraînement unifié améliore les trois capacités par rapport à un entraînement mono-tâche. Le modèle dépasserait des références spécialisées en reconstruction de mains 3D et en prédiction vidéo conditionnée par l'action, sur quatre jeux de données. L'intérêt tient à la question que ce travail tente de trancher : faut-il des modèles distincts pour percevoir, simuler et décider, ou un seul modèle qui partage ses représentations ? Les modèles vision-langage-action (VLA) actuels prédisent surtout des actions, sans modèle explicite des conséquences visuelles. Les générateurs vidéo, eux, produisent de belles séquences sans garantie de cohérence avec un geste physique. Un système unifié servirait à la fois la planification et l'exploitation des vidéos humaines à la première personne, une source de données bien moins chère que la téléopération robotique pour les mains dextres. Il faut toutefois rester prudent : les résultats portent sur de la reconstruction de mains et de la génération vidéo, pas sur un robot réel. Le gain en planification est jugé par un modèle vision-langage, une évaluation indirecte qui ne mesure pas un taux de réussite physique, et aucun chiffre n'est donné dans le résumé. Ce travail s'inscrit dans la montée des world action models, qui rapprochent les modèles du monde vidéo des politiques de contrôle, face à des approches comme Pi-0 de Physical Intelligence ou GR00T de Nvidia, centrées sur l'action. Il reprend aussi l'idée d'apprendre la dextérité à partir de vidéos égocentriques humaines. La page projet est publiée, mais aucun calendrier de déploiement sur robot n'est annoncé. La prochaine étape à surveiller est la conversion de ces trajectoires de mains en commandes pour des mains robotiques, puis une validation en conditions réelles.

UEPas d\'impact direct sur la France/UE

RecherchePaper
1 source